
-
-
インド対米貿易交渉、国益重視で対抗 政権弱体化回避へ「聖域」譲らず
https://www.nikkei.com/article/DGXZQOGM31BJ50R30C25A7000000/『2025年8月2日 2:00 [会員限定記事]
【ムンバイ=岡部貴典、ニューデリー=岩城聡】インドは関税を含む対米貿易交渉で「国益重視」を掲げて対抗する姿勢を強めている。米国が要求する農業・酪農市場の開放を拒み、自国に恩恵のある貿易協定を探る。安易に譲歩すれば農家の反発を招き、政権基盤が揺らぎかねないと恐れる。
トランプ米大統領はインドに25%の相互関税を課すと表明した翌日の7月31日、自身のSNSでインドとロシアを「死んだ経済」だとこきおろ…
この記事は会員限定です。登録すると続きをお読みいただけます。』
-
NVIDIAの巨大GPUを支えるTSMCのインタポーザ技術
https://pc.watch.impress.co.jp/docs/column/kaigai/1064109.html
『後藤 弘茂 (Hiroshige Goto)2017年6月9日 06:00
シリコンインタポーザも半導体技術の限界に制約されている
NVIDIAは、次世代GPUアーキテクチャ「Volta(ボルタ)」ベースのハイエンドGPU「Tesla V100(GV100)」で815平方mmのダイサイズ、現行のPascal(パスカル)の「GP100」で610平方mmと巨大ダイのGPUを投入し続けている。しかし、無制限に大きなダイのGPUを作れるわけではない。GPUのダイサイズには、制約がある。それは、半導体製造工程におけるフォトマスクのサイズだ。
半導体製造工程で露光に使われるフォトマスクでは一定の露光サイズが決まっている。現在はワンショットの露光サイズは33×26mmが主流で、面積では約850平方mmとなる。
GV100の815平方mmというダイサイズは、加工上で必要となる部分を省けば、ほぼギリギリの限界サイズだ。ワンショットによる露光面積は、GPUチップの製造上の明確な限界となっている(2020年以降にハイNAが導入されると、ワンショット露光面積は半分になる)。
しかし、マスクサイズは、じつはPascal世代のGP100のときから問題となっていた。それは、GPUの土台となっているシリコンインタポーザ(Silicon Interposer)のサイズもマスクの露光サイズによって制約されているからだ。NVIDIAは昨年(2016年)のGP100から、ハイエンドGPUのメモリにHBM(High Bandwidth Memory)を採用した。HBMは、シリコン貫通ビア(TSV:Through Silicon Via)技術を使ったスタックドDRAM技術だ。NVIDIAが採用したのは、第2世代のHBM2で、GV100ではメモリ帯域は900GB/sに達する。
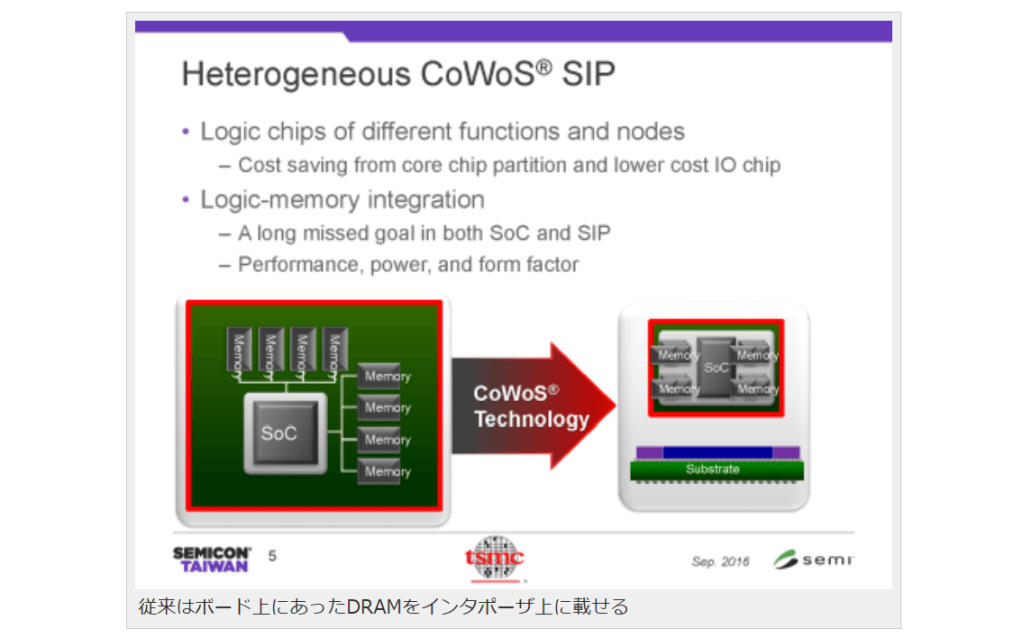
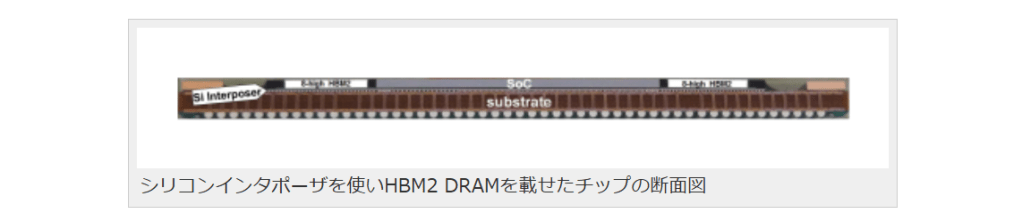
HBMの特徴は、シリコンインタポーザと呼ばれる土台の上にGPUとHBMメモリを配置、チップ間を超高密度の配線で結ぶことで広帯域を実現することにある。NVIDIA GPUでは4個のスタックを載せており、合計4,096-bitのデータバスをシリコンインタポーザで配線している。
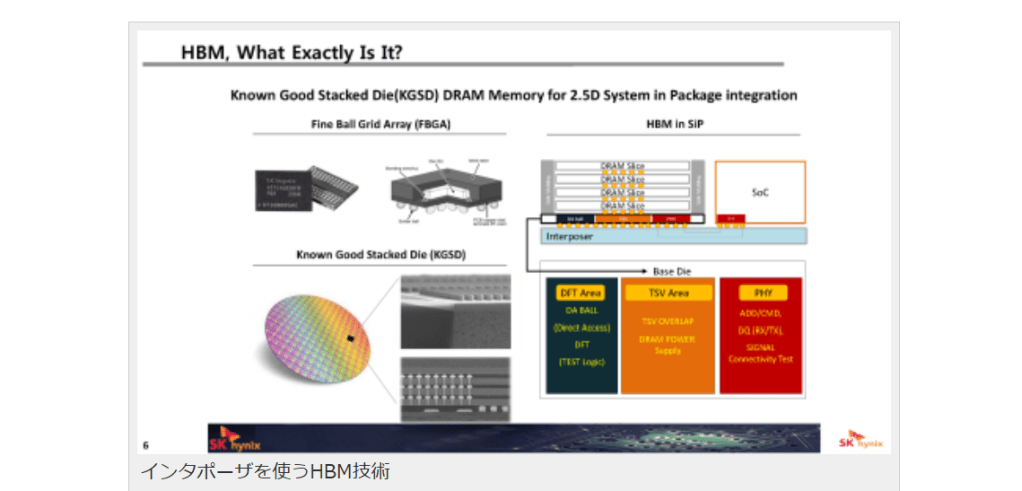
インタポーザを使うHBM技術
従来はボード上にあったDRAMをインタポーザ上に載せる
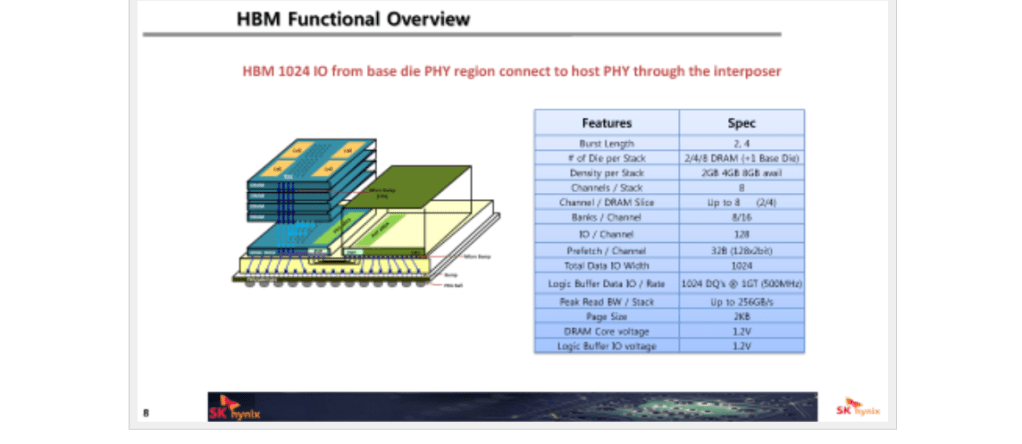
シリコンインタポーザを使いHBM2 DRAMを載せたチップの断面図
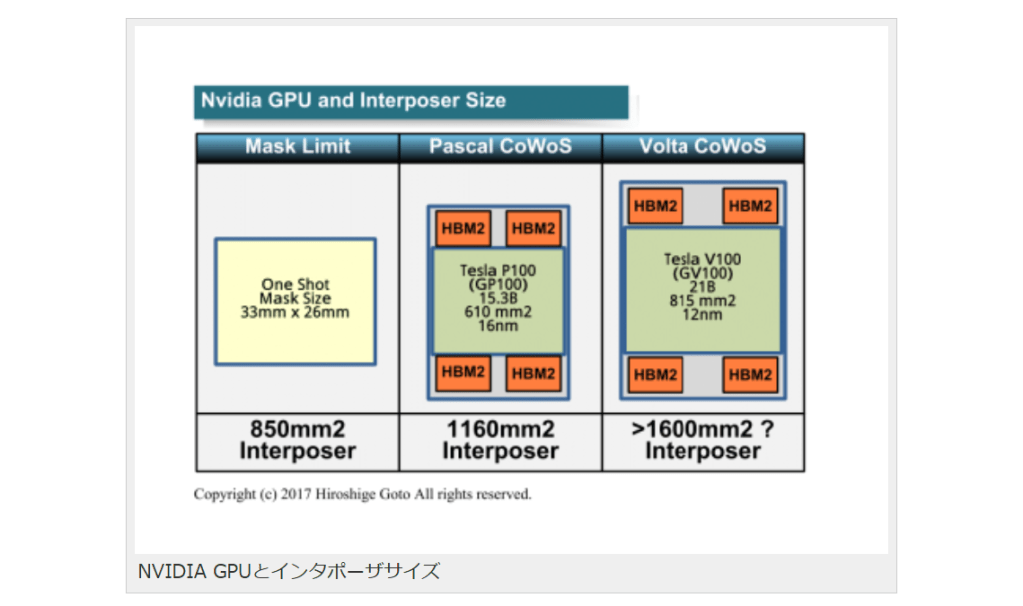
微細な配線を可能にするシリコンインタポーザも、その正体は半導体チップだ。トランジスタは形成しないものの、通常の半導体チップ同様に配線を行ない、TSV技術による縦配線も通す。そのため、シリコンインタポーザにも、GPUチップと同様にマスクサイズの制約がある。ワンショットで露光できる面積は、33×26mmの約850平方mmが上限だ。
ではどうやって、NVIDIAの巨大GPUを載せる巨大インタポーザを作ることができるのか。
NVIDIAが採用したTSMCのパッケージ技術CoWoS
NVIDIAのハイエンドGPUの製造は、ファウンダリ最大手の台湾TSMCが行なっている。インタポーザを使うパッケージングもTSMCの「CoWoS(Chip-On-Wafer-On-Substrate)」技術を使っている。
TSMCは、京都で開催されている半導体学会「2017 Symposia on VLSI Technology and Circuits」(6月5日~6月8日)において、同社の第2世代CoWoS技術の概要を明らかにした(「Wafer Level Integration of an Advanced Logic-Memory System Through 2nd Generation CoWoS technology」W. Chris Chen. VLSI Symposia 2017)。
第2世代のCoWoS2は、NVIDIA GPUなどの大型で高性能なチップやHBM2などの新メモリに最適化した技術となっている。
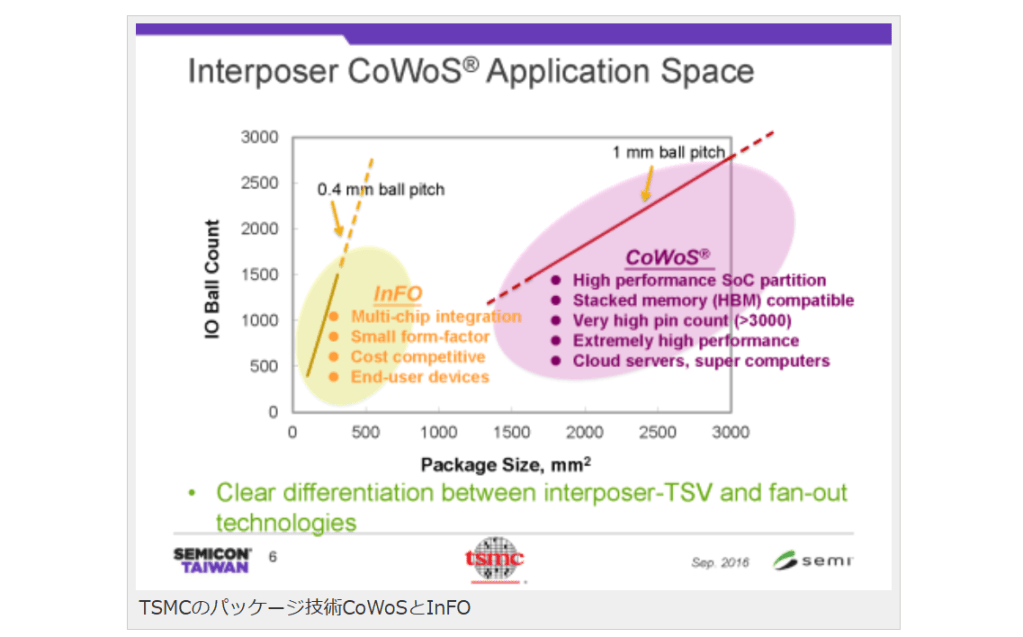
TSMCは現在、パッケージ技術の革新に力を注いでいる。そして、新しいパッケージ技術として「Fan-Out Wafer Level Package(FO-WLP)」技術の「InFO」と、CoWoSを提供している。InFOは、Appleの「iPhone 7」の「A10」プロセッサのパッケージに採用されて一躍有名になった。CoWoSとInFOは大きく異なる技術で、すみ分けている。
TSMCのパッケージ技術CoWoSとInFO
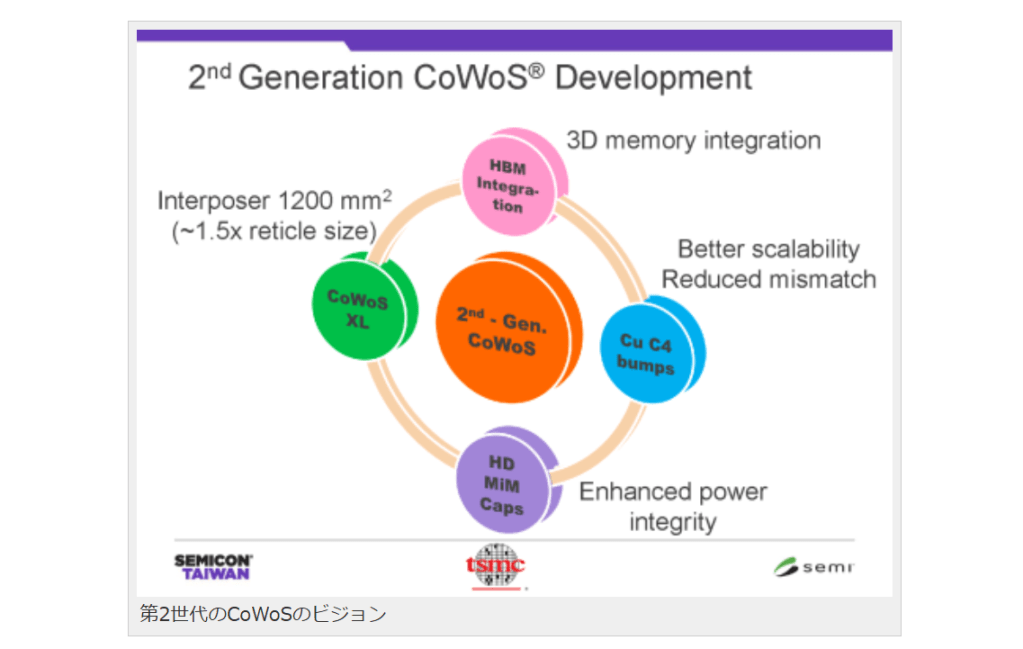
第2世代のCoWoSのビジョン
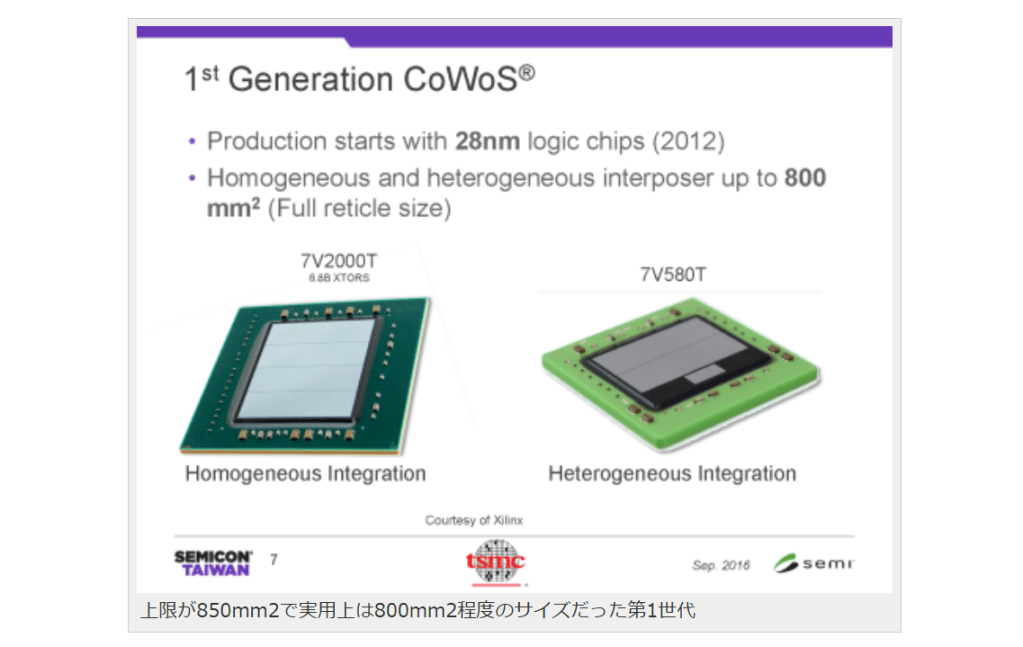
TSMCは2012年にCoWoSを導入。CoWoSは最初はFPGAなどに使われていた。VLSIシンポジウムでは、第1世代のCoWoSでは、インタポーザのサイズが850平方mmまでに制限されていたことが明かされた。最初の世代では、GPUのような大型チップにHBMを組み合わせたCoWoSは不可能だったことになる。
上限が850mm2で実用上は800mm2程度のサイズだった第1世代
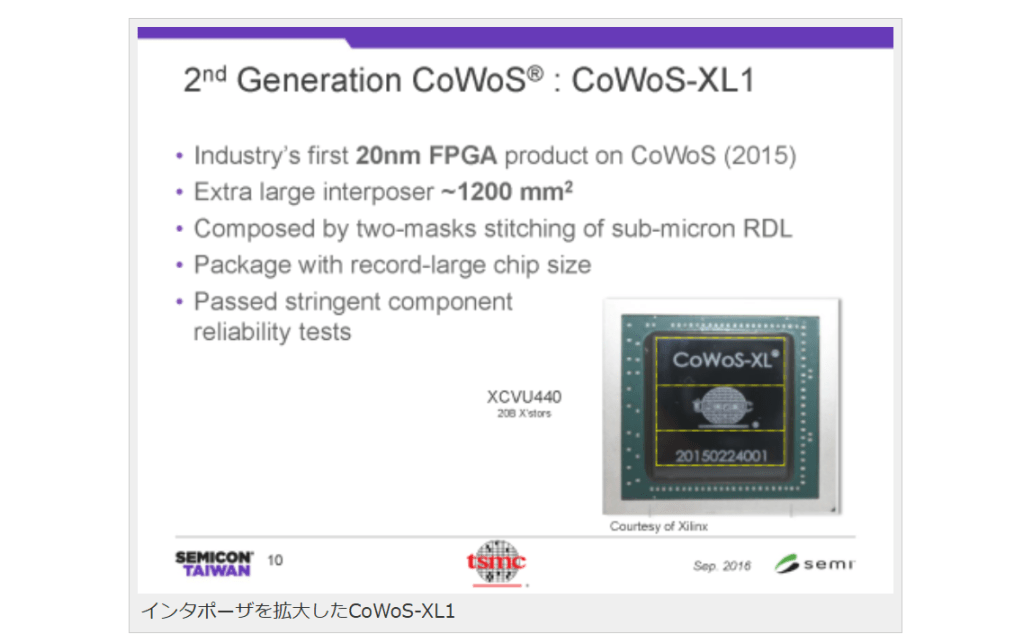
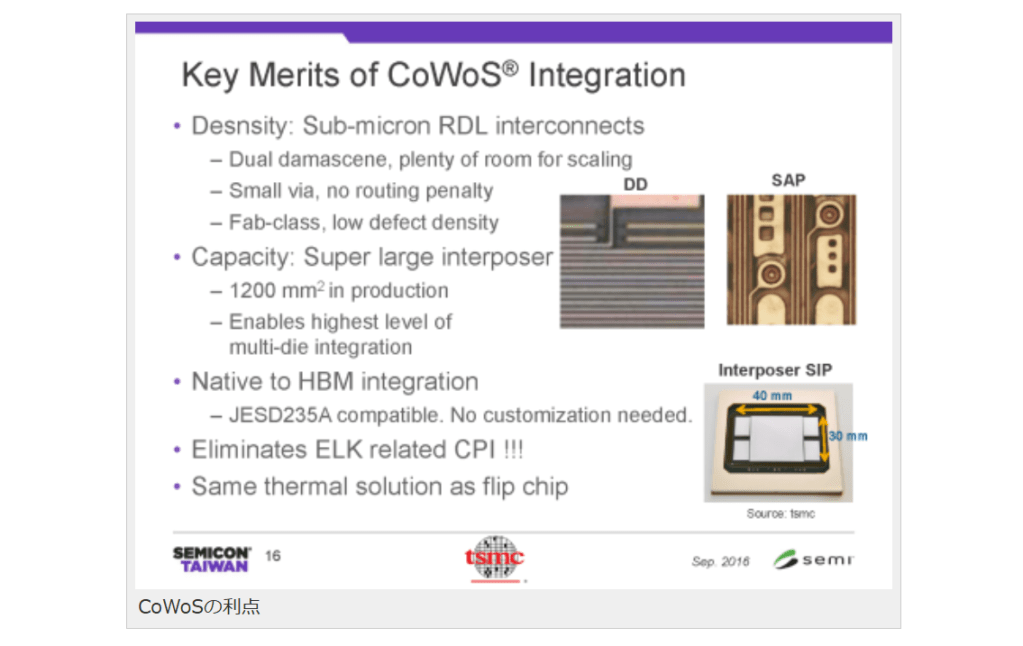
そこで、TSMCは第2世代の「CoWoS-2」の開発を進めてきた。TSMCは、まず、インタポーザサイズの拡大に手を着けた。そして、2015年に1,200平方mmまでの拡張サイズのインタポーザの「CoWoS-XL1」を導入した。
2ショットのスティッチングでインタポーザ面積を拡大
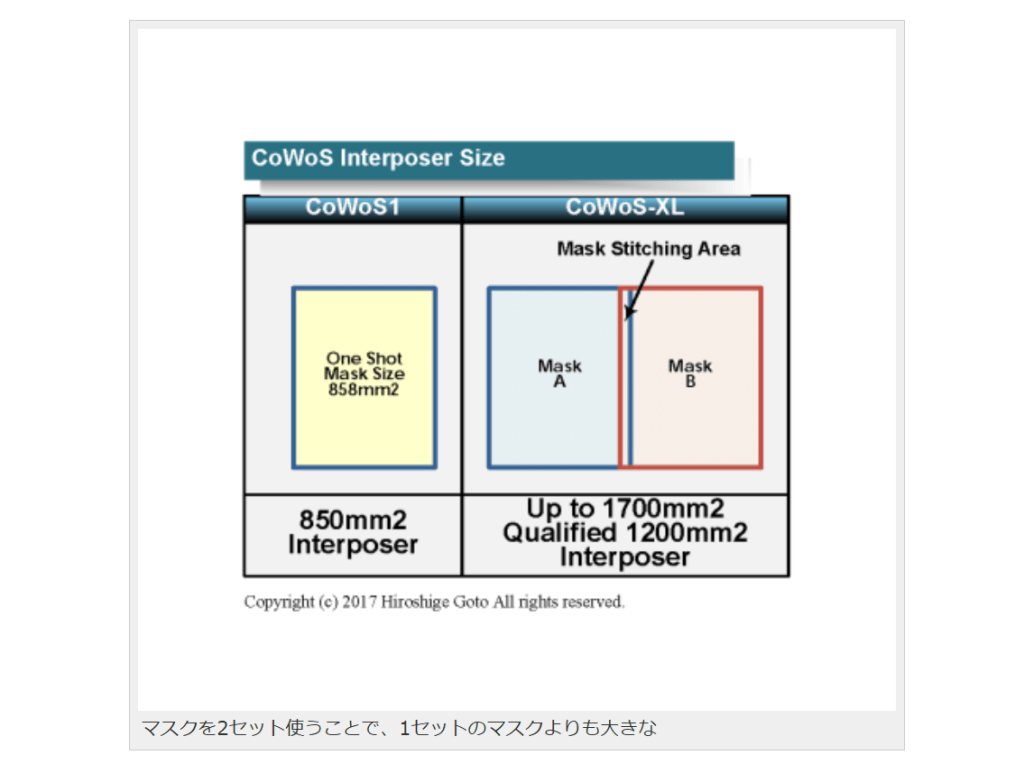
TSMCはVLSIシンポジウムで、CoWoS-XL以降のインタポーザ拡張技術を明らかにした。それによると、マスクを2セット使って「縫いしろ(stitching:スティッチング)」エリアを設けることで、マスク1枚よりも大きなインタポーザダイ(半導体本体)を実現する。
CoWoS-XLによって、2015年には1,200平方mmまでの面積のインタポーザが適合できたという。
インタポーザを拡大したCoWoS-XL1
マスクを2セット使うことで、1セットのマスクよりも大きな
エリアのインタポーザを実現するCoWoS-XL技術2016年のNVIDIAのPascal GP100は、この第2世代のCoWoS技術であるCoWoS-XLを採用している。
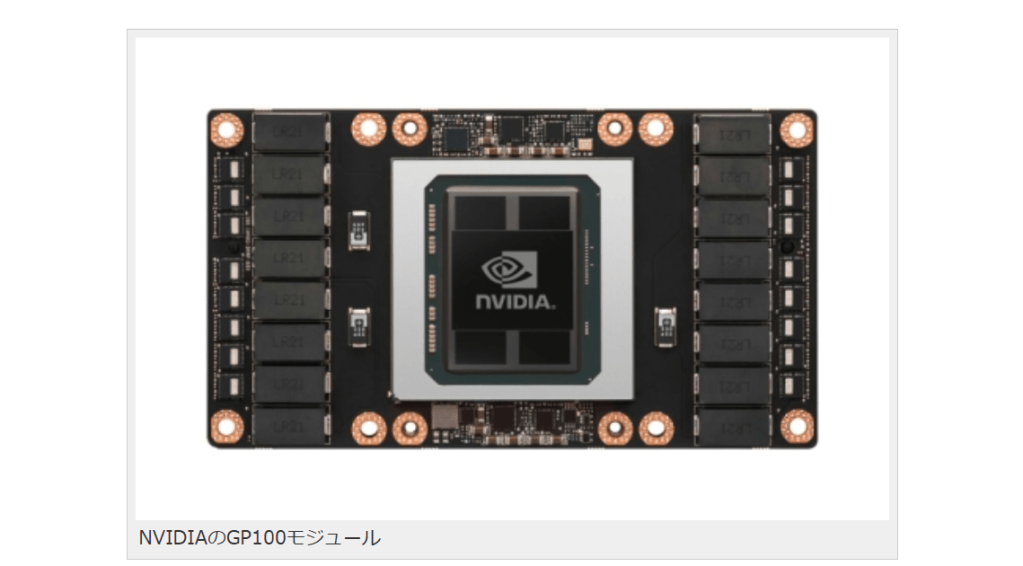
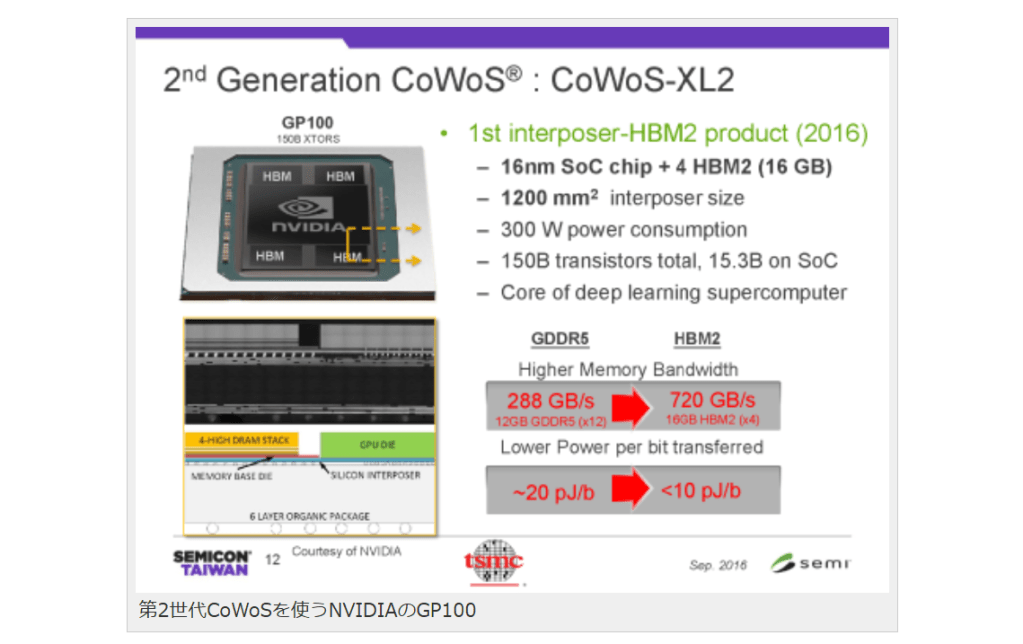
CoWoS-XLは、610平方mmのGP100 GPUダイに、4個のHBM2スタックを、インタポーザ上に載せている。そのため、Pascal GP100のインタポーザ面積は約1,160平方mm(スライドでは1,200平方mmとなっている)となり、当然850平方mmのワンショットサイズには収まらない。そのため、2マスクセットによるスティッチングで、拡大インタポーザとしている。
NVIDIAのGP100モジュール
第2世代CoWoSを使うNVIDIAのGP100
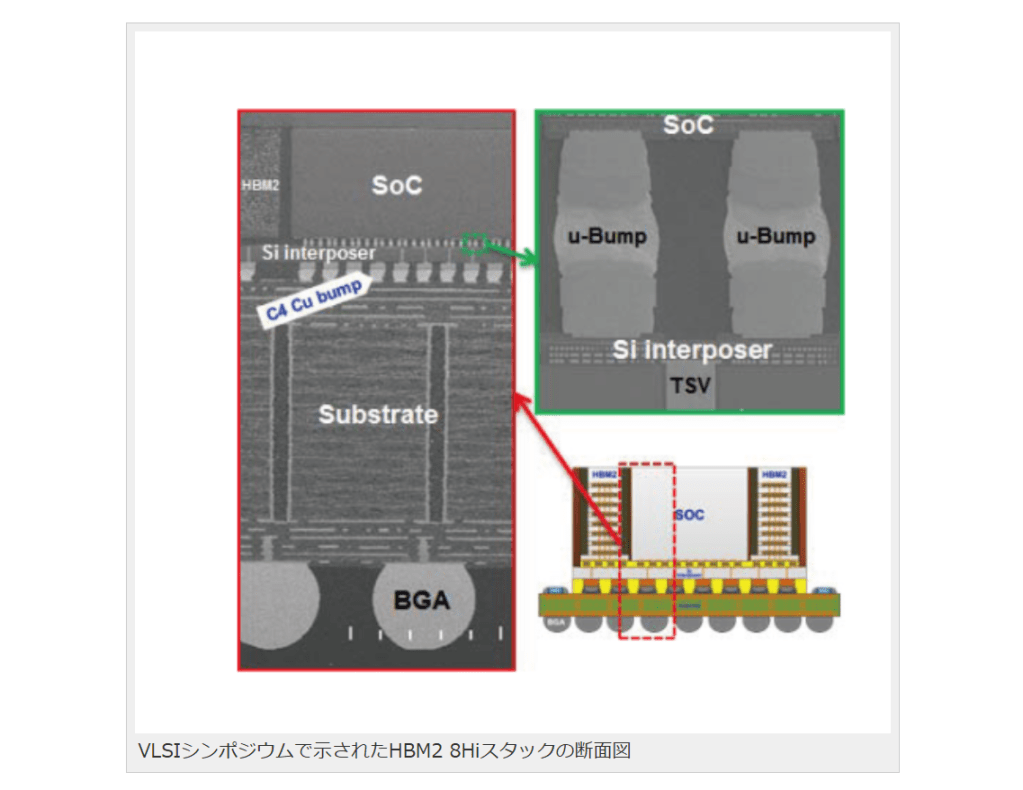
VLSIシンポジウムで示されたHBM2 8Hiスタックの断面図
GP100のHBM2メモリは、8MbitsのDRAMダイを4層にTSVで積層した「4Hi」構成となっている。GPUが153億トランジスタで、DRAMと合わせて1,500億トランジスタとなる。
CoWoS2の限界に近いインタポーザ面積を使う「Volta」
TSMCは、VLSIシンポジウムにおいて、CoWoS2では、最大1,700平方mmのインタポーザが可能であることを明らかにした。2ショットなら、計算上これが限界の面積となる。
そして、この面積は、NVIDIAが今年(2017年)投入する次世代GPU「Volta」のスペックと合致している。
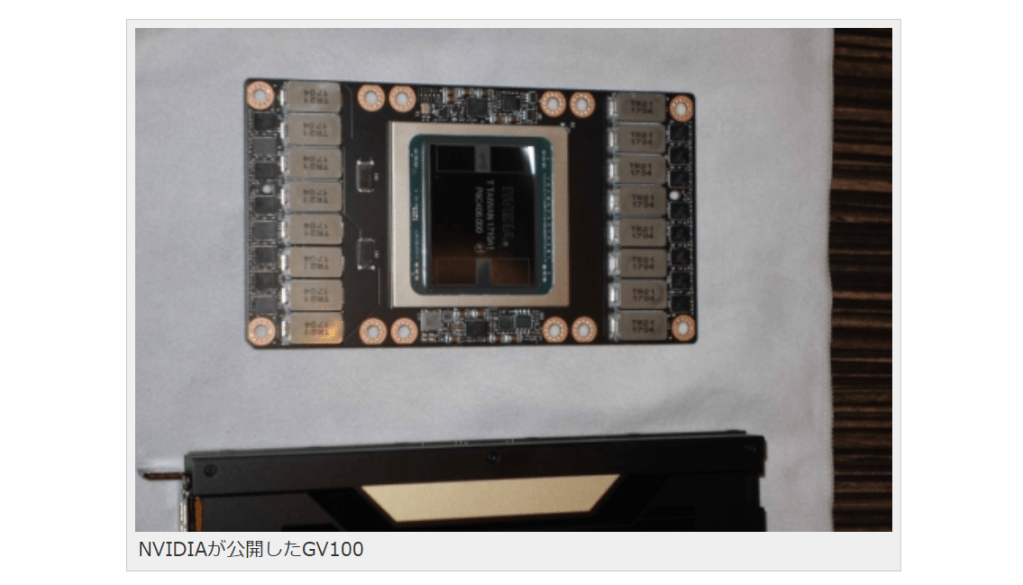
NVIDIAは、Volta GV100では、GPUダイを815平方mmに拡大し、HBM2を4スタック使った。この構成では、インタポーザサイズが1,600平方mm前後必要になると見られる。つまり、Voltaは、GPUダイがマスクの限界であると同時に、インタポーザもCoWoS2の限界となっている。二重に限界まで使っているのがVoltaだ。
NVIDIA GPUとインタポーザサイズ
NVIDIAが公開したGV100
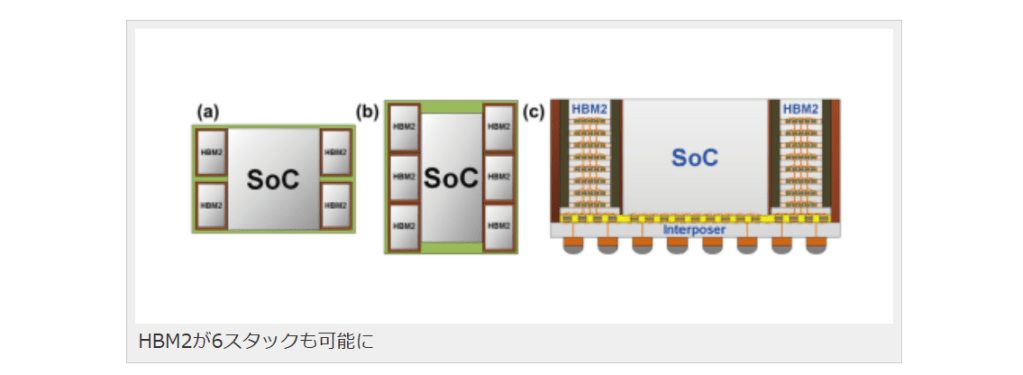
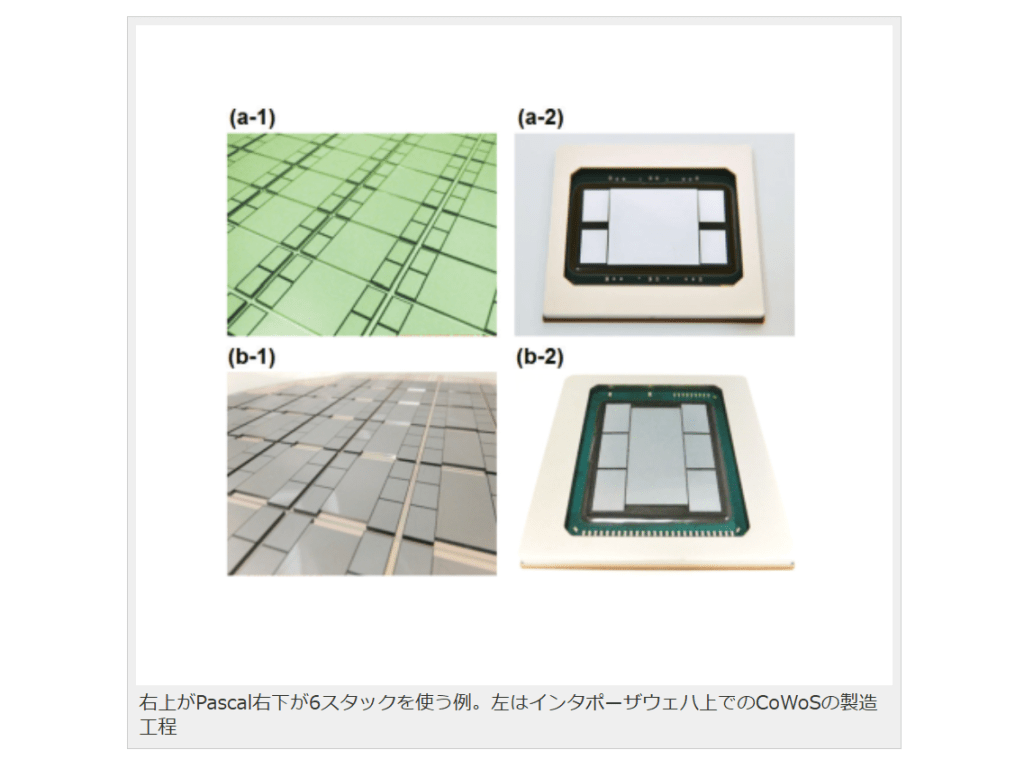
また、TSMCはVLSIシンポジウムで、今年中にCoWoS2によって6個のHBM2スタックを搭載した製品が登場すると発表した。GPU以外でもHBM2を使う大型ダイが浸透しつつある。
HBM2が6スタックも可能に
右上がPascal右下が6スタックを使う例。左はインタポーザウェハ上でのCoWoSの製造工程
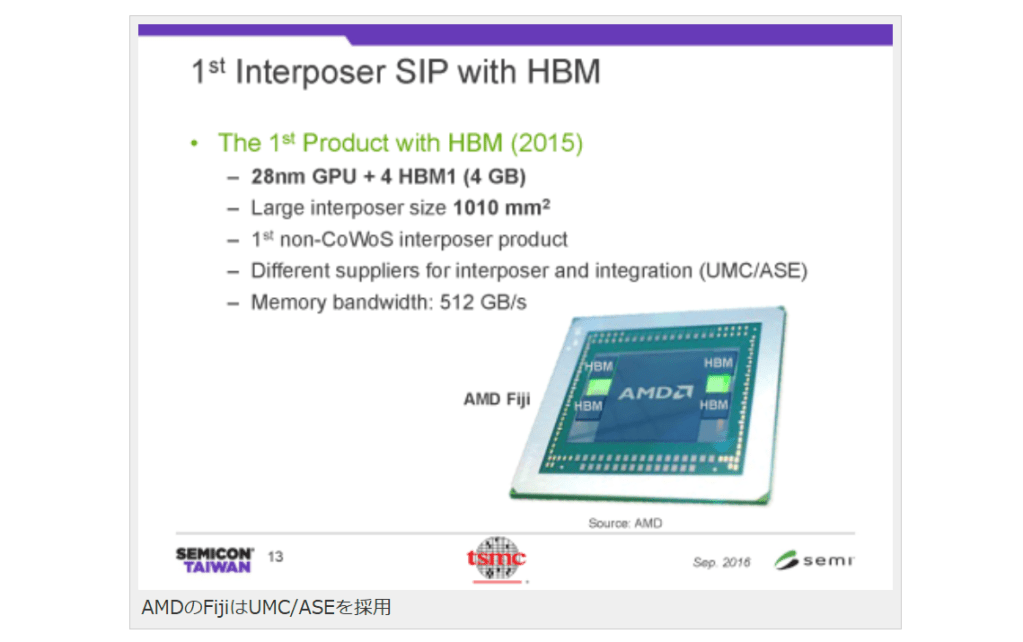
ちなみに、2015年にAMDが発売した初のHBM採用GPU「Radeon R9 Fury(Fiji)」は、HBM1メモリを使ってインタポーザに載せているが、こちらはTSMCのパッケージ技術は使っていない。Fijiダイ自体はTSMCの28nmプロセス製造だが、台湾のパッケージベンダーASEがパッケージングを、台湾ファウンダリUMCがインタポーザを提供している。
TSMCはCoWoSとInFOによって、ファウンダリであるTSMCがパッケージングも取りこもうとしている。NVIDIAのCoWoS採用やAppleのInFO採用は、TSMCによるファウンダリ+パッケージングの垂直ソリューションの好例だ。
それに対して、AMDのFijiは、TSMCによる垂直型のパッケージングではなく、パッケージングを別ベンダーが提供する従来の水平分散モデルを取っている。
これは、AMDがFijiを開発した時点では、大型ダイのGPUへのHBM搭載はまだ模索状態で、パッケージベンダーとして実績のあるASEに助けを求めたためと言われている。ちなみに、Fijiも、1,010平方mmの拡大インタポーザを使っており、UMCがTSMCと類似のアプローチをとったと見られる。ただし、TSMCとは製造工程が異なると思われる。
AMDのFijiはUMC/ASEを採用
TSMCのCoWoSは、製造工程においてシリコンインタポーザのウェハのままで、ダイの積層などの工程をすべて行なってしまう。
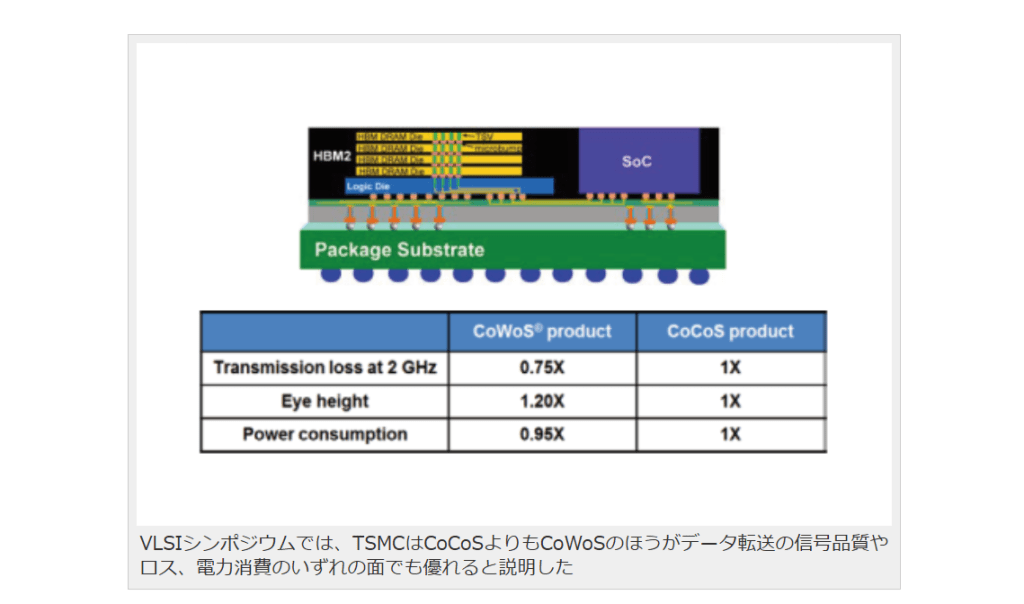
ほとんどの工程が終わってから、ダイに切り分ける(ダイシング)。それに対して、インタポーザを切り分けてから積層やバンプ接続などの工程を行なう方法があり、「CoCoS(Chip-On-Chip-On-Substrate)」と呼ばれる。FijiはCoCoSで製造されているとTSMCは説明する。
また、TSMCは、自社のCoWoSが技術的にCoCoSよりも有利であると説明する。簡単に言えば、同じようにHBM2を使っていても、パッケージ技術によって差が出るとTSMCは主張している。
具体的には、CoWoSでは、GPUダイとHBM2スタックのベースロジックダイの間を極めて近接して配置できるという。
VLSIシンポジウムでは、TSMCはCoCoSよりもCoWoSのほうがデータ転送の信号品質やロス、電力消費のいずれの面でも優れると説明した
HBM2世代の巨大GPUに最適化したCoWoS2
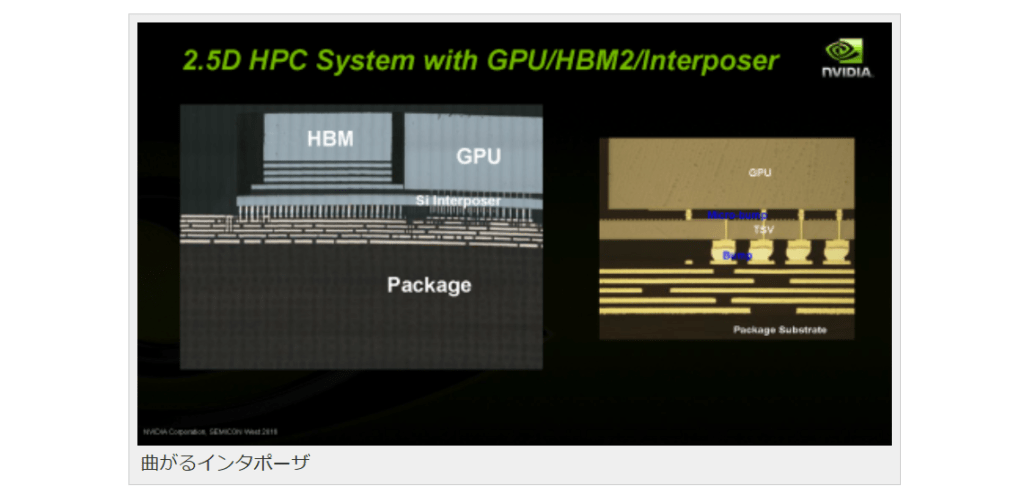
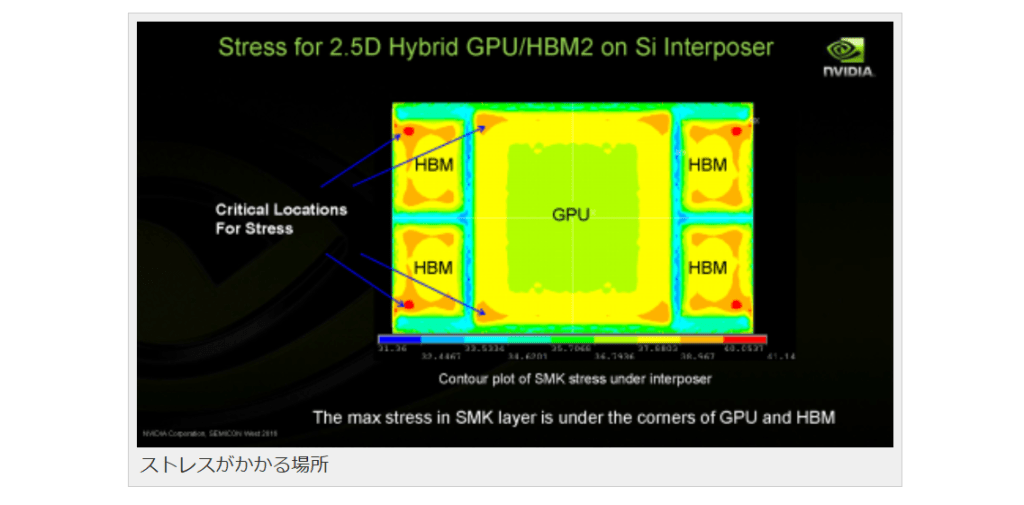
面積が大きなインタポーザの難点の1つは、メカニカルなストレスに弱いことだ。極めて薄いインタポーザ上に積層したHBM2などを積むため、ゆがみやすい。
この問題は、NVIDIAが、昨年の半導体カンファレンス「Semicon West」で指摘していた。ただ、NVIDIAはこれをシステムレベルのマテリアルとプロセスの最適化によって解決できると説明している。
曲がるインタポーザ
ストレスがかかる場所
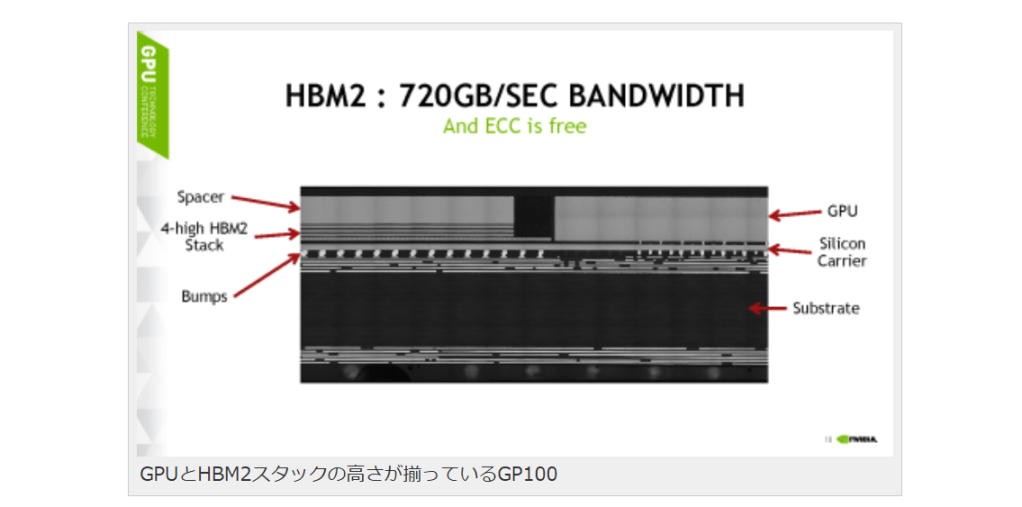
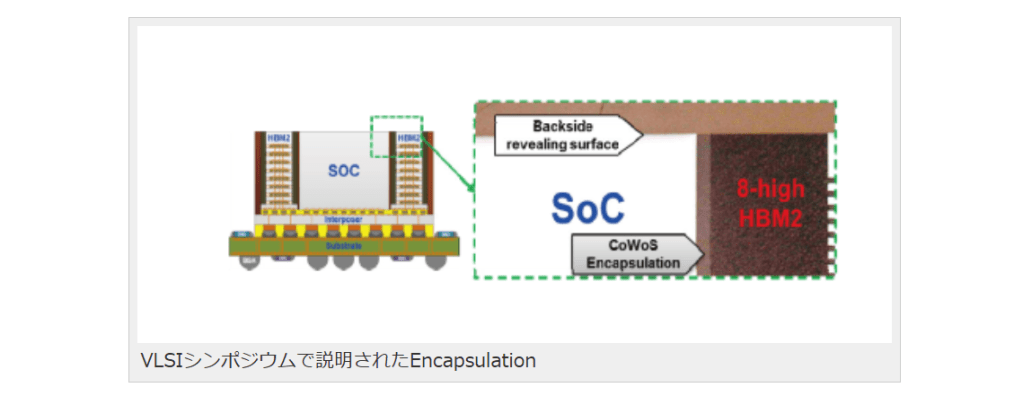
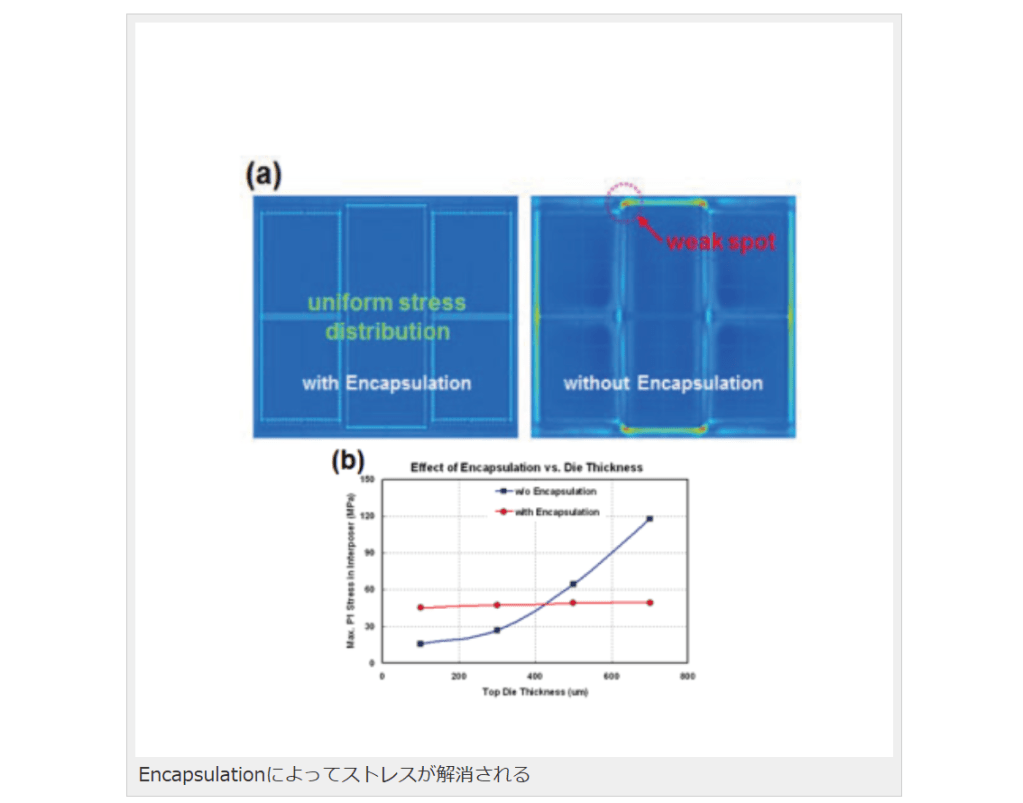
VLSIシンポジウムでは、TSMCから最適化の方法などが明らかにされた。ポイントはGPUダイとHBM2スタックという異なる種類のダイ/スタックの高さを揃えること。同厚に揃えることで、ヒートスプレッダからのストレスを均等に分散する。TSMCはこれを「Encapsulation(カプセル化)」と呼んでいる。
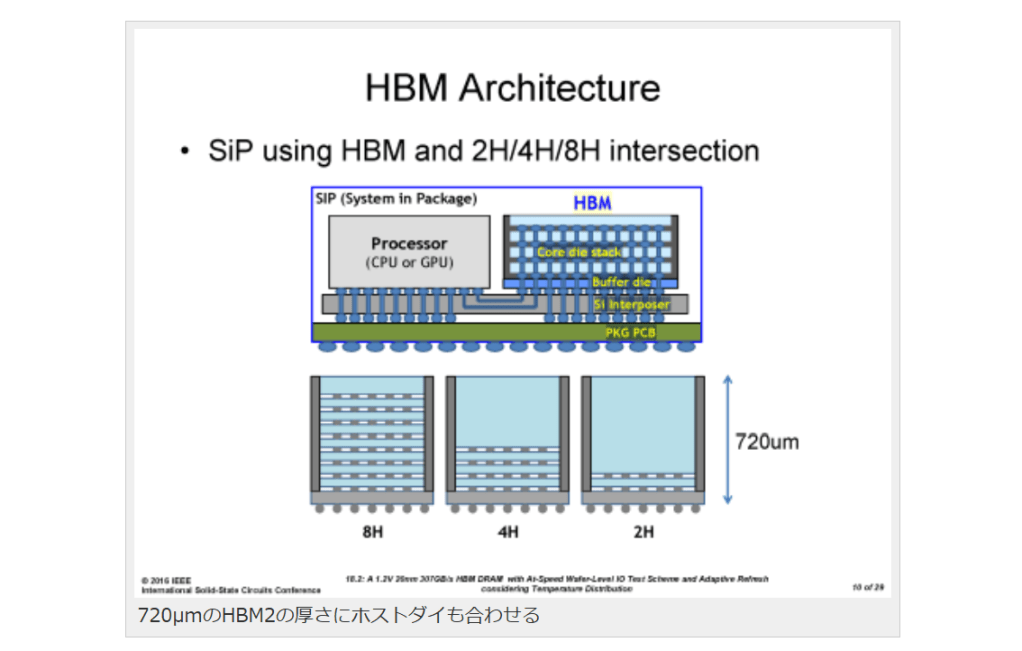
HBM2のスタックは、8Hi(8ダイの積層)を見越して720μmに揃えられている。GPU側もその厚さに厳密に合わせると見られる。これによって、信頼性と排熱がより向上する。
GPUとHBM2スタックの高さが揃っているGP100
VLSIシンポジウムで説明されたEncapsulation
Encapsulationによってストレスが解消される
720μmのHBM2の厚さにホストダイも合わせる
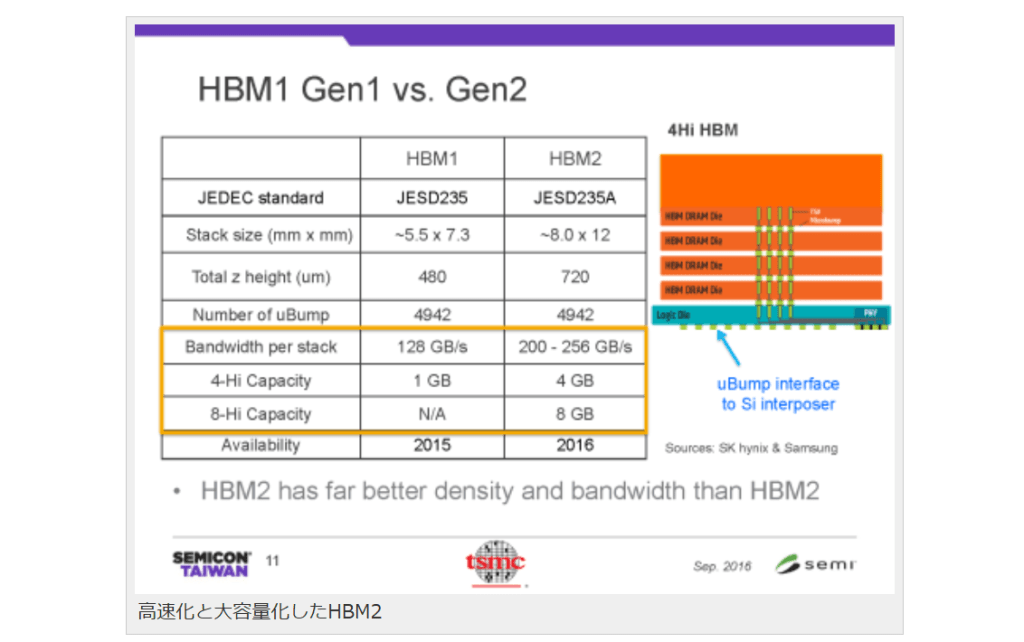
NVIDIA GPUが採用したHBM2は、最初のHBM1に対してデータ転送レートが最大2倍の2Gtps(Giga transfer per second)にまで上がる。
また、8個のダイを積層する8Hiも可能になる。そのため、信頼性や信号品質が重要となる。TSMCはCoWoSではその点も強味があるとしている。
高速化と大容量化したHBM2
CoWoSの利点 』
-
GPUモジュールも将来はウェハサイズに。第2世代の「SoW」をTSMCが開発中
https://pc.watch.impress.co.jp/docs/column/semicon/2035515.html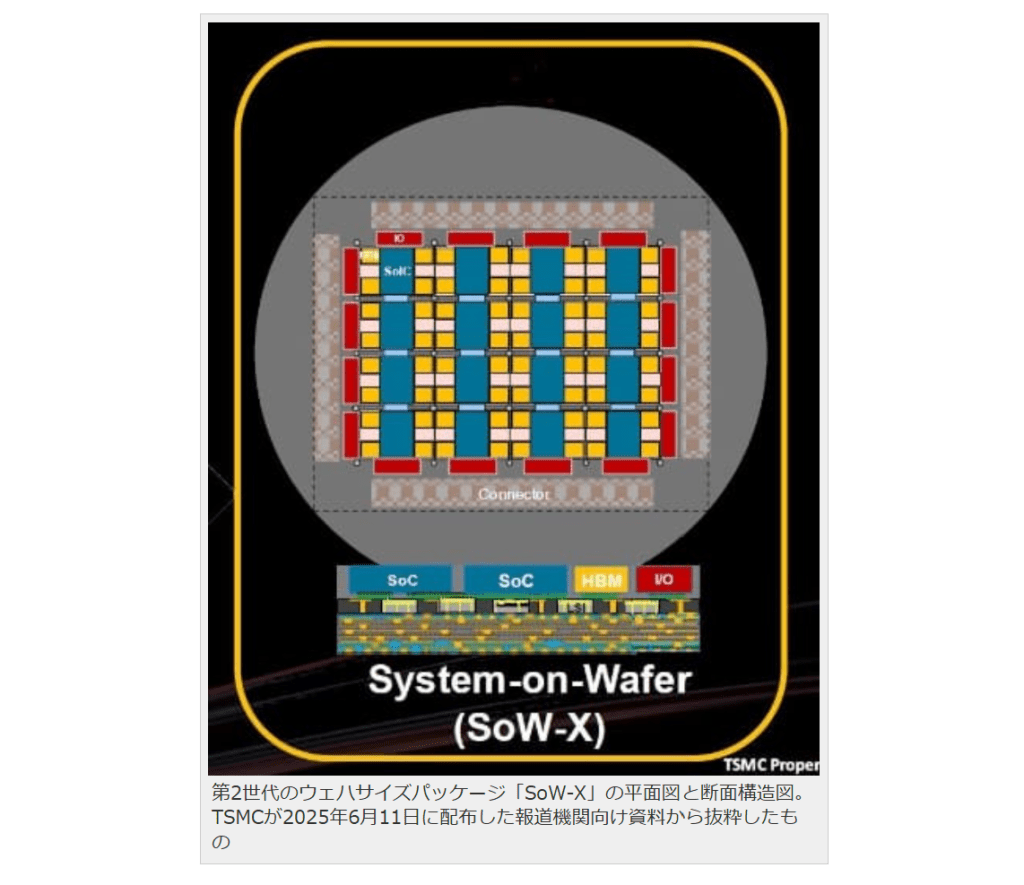
『福田 昭2025年7月31日 10:07
第2世代のウェハサイズパッケージ「SoW-X」の平面図と断面構造図。TSMCが2025年6月11日に配布した報道機関向け資料から抜粋したもの
TSMCはこのほど、直径が約300mmと巨大なシリコンウェハあるいは同じサイズの円板状キャリアにシステムを集積する超大型パッケージング技術「システム・オン・ウェハ(SoW: System on Wafer)」の「第2世代品」を開発していることと、その技術概要を公表した。
SoWは、ミニダイ(チップレット)やチップレットの積層モジュール、メモリモジュール、電源モジュール、入出力、放熱プレートなどを直径が約300mmと巨大な円板状キャリアの両面に搭載する。
ミニダイやメモリなどは再配線層(RDL)を通じて高密度かつ近距離で相互に接続し、超広帯域の信号伝送を実現する。
直径が約300mmの円板という形状とサイズは、半導体製造装置がごく普通に扱う形状とサイズでもある。
このため、半導体製造の要素技術を適用しやすい。既存の製造装置をベースにしたカスタマイズが比較的容易というメリットもある。
TSMCはSoWの第1世代品「InFO_SoW」を2019年に開発し、量産を始めた。
この第1世代品を同社は、「InFO_(Integrated Fan-Out、基本的にはFO-WLPと同じ)」技術のRDLサイズを、直径が約300mmの円板に拡大したパッケージング技術と位置付けていた。
第1世代品InFO_SoWの技術概要と応用事例は、本コラムの前回で解説した。ご興味のある方は参照されたい。関連記事
【福田昭のセミコン業界最前線】スケールが桁違い。TSMCが注力する超大規模高速パッケージ「SoW」とは
第1世代品はロジック、第2世代品はロジックとメモリを集積
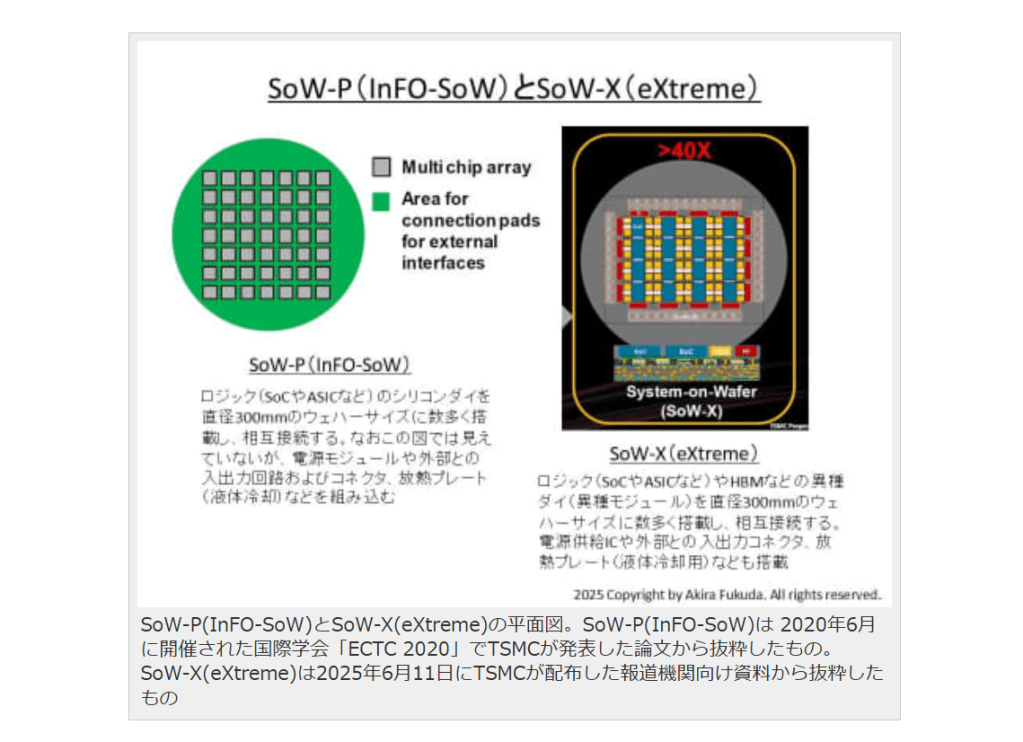
本コラムの前回末尾でも述べたように、TSMCはSoWの第1世代品を「SoW-P」に改称するともに、第2世代品を「SoW-X(eXtreme)」と名付けた。
同社は2025年5月下旬に米国で開催されたパッケージング技術の国際学会ECTC 2025で、SoW-Pは主要回路としてSoCだけを300mmウェハサイズに集積する技術であるのに対し、SoW-Xは主要回路としてSoCとHBMを混載する異種集積(ヘテロジニアス・インテグレーション)技術だと口頭で説明していた。
SoW-P(InFO-SoW)とSoW-X(eXtreme)の平面図。SoW-P(InFO-SoW)は 2020年6月に開催された国際学会「ECTC 2020」でTSMCが発表した論文から抜粋したもの。
SoW-X(eXtreme)は2025年6月11日にTSMCが配布した報道機関向け資料から抜粋したもの
第2世代品は高性能パッケージ「CoWoS」の発展形
もう1つの大きな違いは、第1世代品がInFO技術の大型化であるのに対し、第2世代品は高性能パッケージ「CoWoS(Chip on Wafer on Substrate)」を大型化したものであることだ。
CoWoSでは、パッケージ基板(樹脂基板)とシリコンダイ(マルチチップ)の間に別の基板(中間基板またはインタポーザと呼ばれる)を挟む。
RDLはビア径/間隔と配線幅/間隔がパッケージ基板よりもはるかに小さい。
隣り合うチップの間隔を大幅に短くするとともに、入出力配線の密度を大きく高められる。
単位長当たりのデータ転送速度が著しく上昇する。
CoWoSの中間基板には当初、シリコン基板(Siインタポーザ)が選ばれた。
シリコンの中間基板はシリコンダイと熱膨張率がほぼ同じなので、温度変化による歪みが原理的には起こらない(実際には製造工程に工夫が必要)。
CoWoSの初期製品は2012年に登場した。
FPGAの大手メーカー2社が、FPGAのマルチチップモジュールに採用した。
たとえば1つはFPGAの同じダイ4枚をSiインタポーザ上に近接配置したモジュール、もう1つはFPGAのダイ1枚とメモリのダイ1枚をSiインタポーザ上に近接配置したモジュールである。
Siインタポーザの面積は最大775平方mmで、ArFスキャナの露光領域858平方mmにかなり近い。1枚のマスク(レチクル)で露光できるギリギリのサイズだとも言える。
CoWoSの巨大化を牽引したブレークスルー「スティッチング」
CoWoSの実質的な普及は2016年の第2期から始まったと言えよう。
ArFスキャナの露光領域858平方mmを超える、巨大なSiインタポーザを量産できるようになったことが大きい。
GPU大手のNVIDIAが大規模GPU「GP100」のパッケージにSiインタポーザ技術を採用したのだ。
GPUチップGP100を1個と、HBM2モジュールを4個、Siインタポーザに混載した。Siインタポーザの面積は1,160平方mmである。
Siインタポーザ1枚の製造には2枚のマスクを使う。
マスクで露光する長方形領域の1辺をわずかに重ねてつなぐことにより、マスク1枚の露光面積をはるかに超える大きさのSiインタポーザを作る。
このつなぎ合わせ技術は「スティッチング(Stitching)」と呼ばれる。
2枚のマスクを使うことで、理論的には1,700平方mm近い大きさのSiインタポーザを製造できる。
関連記事
【後藤弘茂のWeekly海外ニュース】NVIDIAの巨大GPUを支えるTSMCのインタポーザ技術
スティッチングの開発と改良により、レチクルの3.3倍もの面積に達するSiインタポーザが2023年には製造可能になった(Siインタポーザ当たりで4枚のマスクを使って回路パターンをつなぐ)。
しかしこの段階で、Siインタポーザのこれ以上の拡大は難しくなりつつあった。
インタポーザのコアであるシリコンの材料コストとシリコン貫通ビア(TSV)の製造コストが、インタポーザのサイズ拡大とともに増加し、顧客にとって許容が難しくなってきた。
レチクルの3.3倍でSiインタポーザの大型化は限界にそこでシリコンよりもコストの低い有機樹脂をコアに選択したインタポーザがCoWoSに使われるようになってきた。このCoWoS技術は大別すると3種類ある。
1つはRDLをインタポーザとする「CoWoS-R」、もう1つは「ローカルシリコンインターコネクト(LSI: Local Silicon Interconnect)」と呼ぶシリコンの小片(ブリッジ)を樹脂コアに埋め込む「CoWoS-L」、3番目はLSIとRDLを組み合わせた「CoWoS-L/R」である。
なおSiインタポーザを採用した従来のCoWoSは、最近では区別のために「CoWoS-S」と呼称が変更されている。
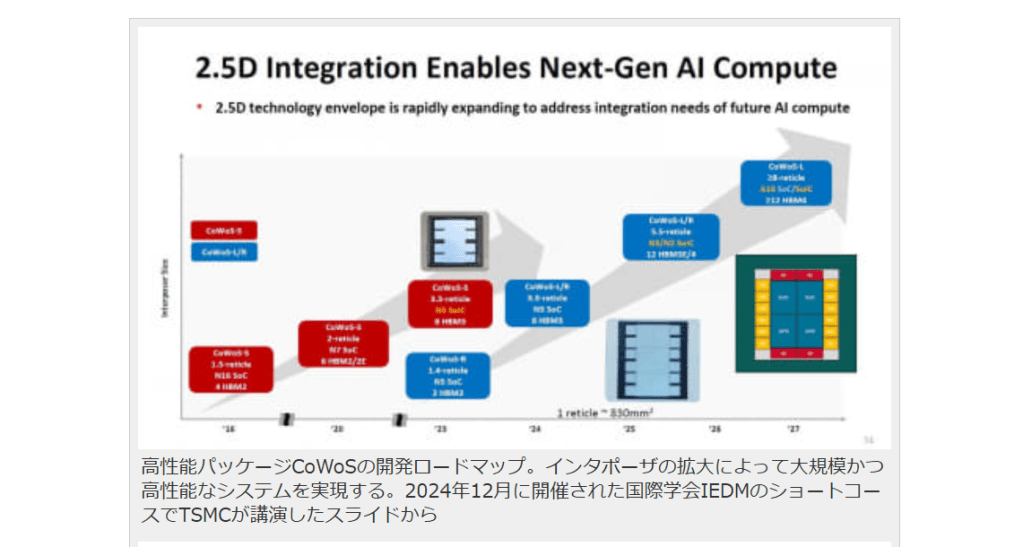
高性能パッケージCoWoSの開発ロードマップ。インタポーザの拡大によって大規模かつ高性能なシステムを実現する。2024年12月に開催された国際学会IEDMのショートコースでTSMCが講演したスライドから
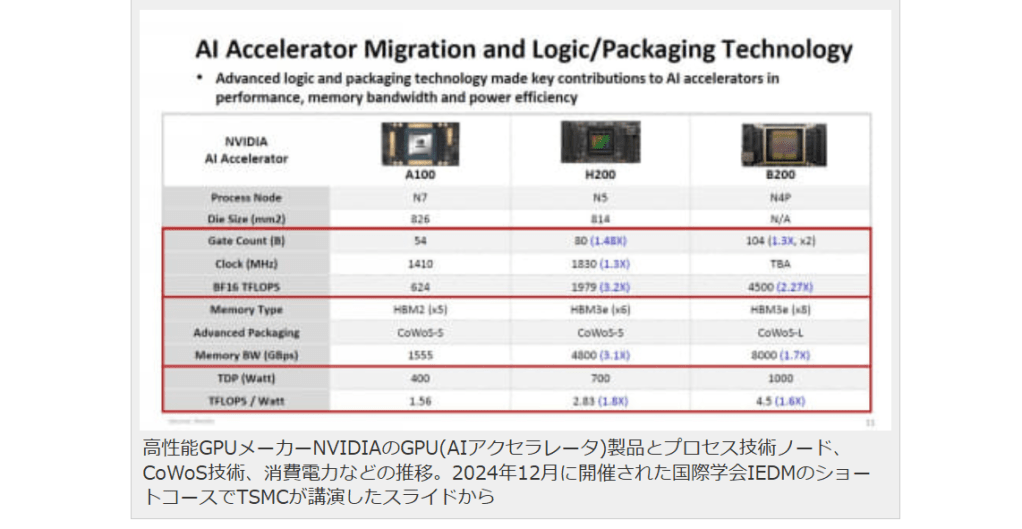
高性能GPUメーカーNVIDIAのGPU(AIアクセラレータ)製品とプロセス技術ノード、CoWoS技術、消費電力などの推移。2024年12月に開催された国際学会IEDMのショートコースでTSMCが講演したスライドから
CoWoS-Rの量産は、中間基板がレチクルの1.4倍と小さめのサイズから始まった。
続いてレチクルの3.3倍と、CoWoS-Sと同じ大きさの中間基板を使うCoWoS-L/Rを開発して量産を始めた。
この段階でCoWoS-Sは開発ロードマップから消え、CoWoS-L/RまたはCoWoS-Lによって中間基板のサイズを拡大する開発ロードマップに換わった。
CoWoSからSoWへ
2024年12月時点でのCoWoS技術の開発ロードマップは、2025年~2026年にレチクルの5.5倍と大きな中間基板を備えるCoWoS-L/Rを開発し、2026年~2027年にレチクルの8倍を超える巨大な中間基板を備えるCoWoS-Lを開発する計画となっている。
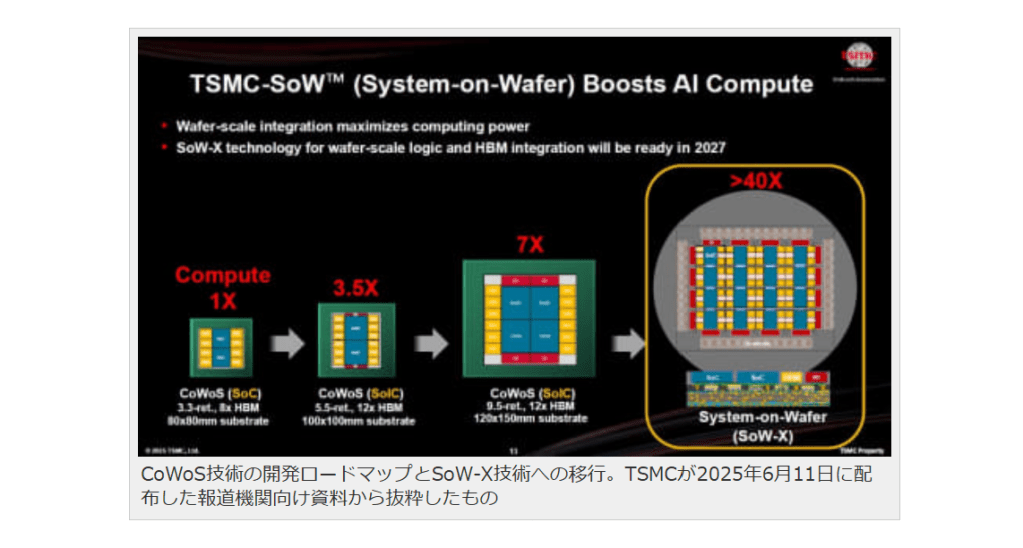
そして2025年6月11日にTSMCが配布した報道機関向け資料では、CoWoS技術の開発ロードマップは以下のようになっていた。
始めは中間基板がレチクルの3.3倍となるCoWoSである。2個のSoCと8個のHBMモジュールを中間基板に搭載した。パッケージの大きさは80mm角である。
次に中間基板をレチクルの5.5倍に拡大したCoWoSを開発する。シリコンダイを3次元積層したSoIC(System on Integrated Chips)を2つ、それから12個のHBMモジュール、2個の入出力回路(IO)を中間基板に載せる。パッケージの大きさは100mm角である。
その次は、中間基板をレチクルの9.5倍に拡大したCoWoSを開発する。シリコンダイを3次元積層したSoICを4つ、それから12個のHBMモジュールを中間基板に載せる。パッケージ基板の大きさは120×150mmに達する。
このCoWoSが、2024年12月時点での開発ロードマップで示された「レチクルの8倍を超える巨大な中間基板を備えるCoWoS-L」に相当するとみられる。
CoWoS技術の開発ロードマップとSoW-X技術への移行。TSMCが2025年6月11日に配布した報道機関向け資料から抜粋したもの
そしてレチクルの9.5倍に中間基板を拡大したCoWoSの次に考えられているのが、300mmウェハ全体から1個のシステムモジュールを切り出すSoWである。
基本単位(ユニット)は中間基板をレチクルの5.5倍に拡大したCoWoSで、ロジックを2つと12個のHBMで構成する(基本ユニットを構成するロジックの数とHBMの数は変わる可能性がある)。
基本ユニットを2次元マトリクス状に配置して相互に接続し、大規模化と高性能化、性能あたりの消費電力低減を鼎立させる。
上下分離のRDLと3種類のシリコンブリッジを駆使
パッケージング技術の国際学会ECTC 2025でTSMCが公表したSoW-X技術は、CoWoS-L技術をベースとする。
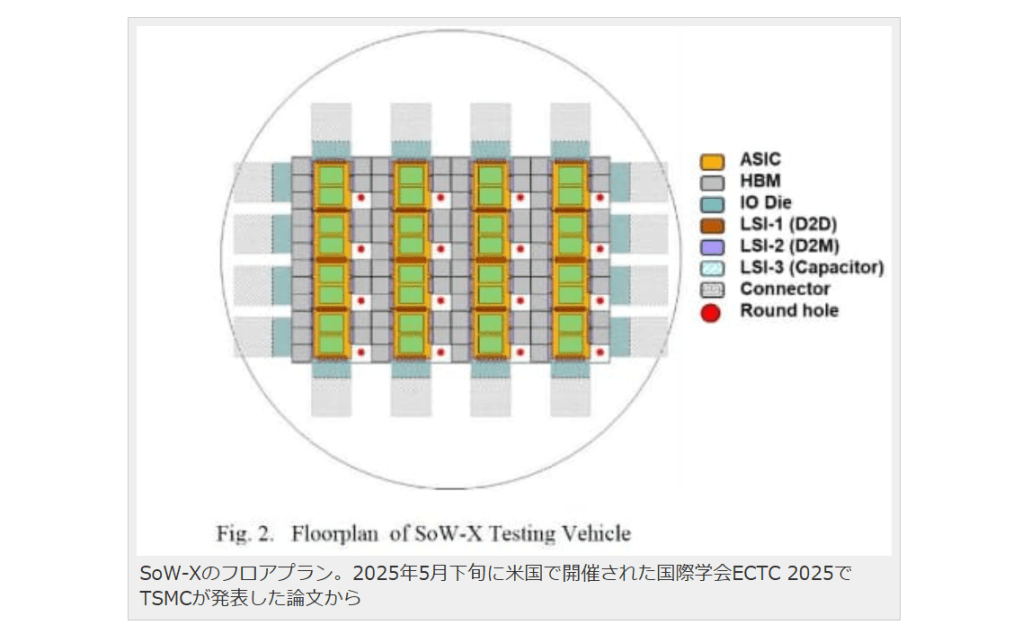
基本ユニットは1個のASIC(ロジック)とその両隣に5個のHBMを配置したサブモジュールである。
原理的にはHBMの最大数は6個なのだが、放熱部を含めたシステム全体を貫通して固定する柱(ピラー)が必要なため、HBM1個分の領域が柱の孔開け用となっている。
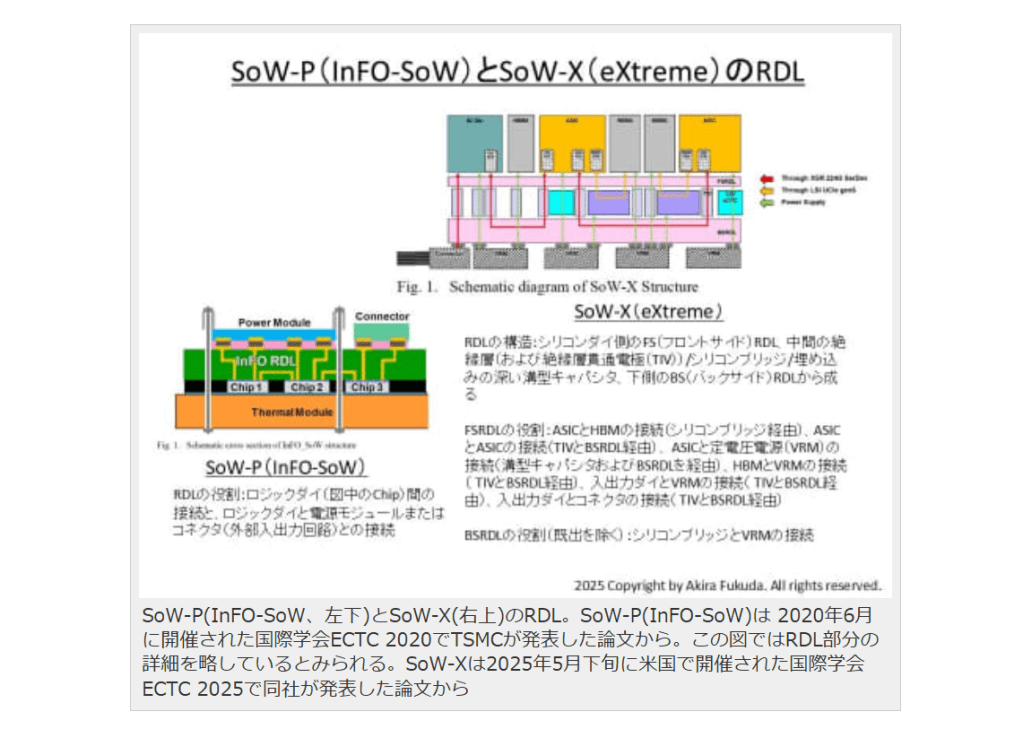
中間基板は上部(シリコンリコンダイ側)にフロントサイドRDL(FSRDL)、中央部に樹脂コア(および樹脂貫通電極(TIV: Through Insulator Via))とローカルシリコンインターコネクト、下部にバックサイドRDL(BSRDL)で構成した。BSRDLの下側には定電圧モジュール(VRM)と入出力回路(コネクタを含む)を配置している。
SoW-P(InFO-SoW、左下)とSoW-X(右上)のRDL。SoW-P(InFO-SoW)は 2020年6月に開催された国際学会ECTC 2020でTSMCが発表した論文から。この図ではRDL部分の詳細を略しているとみられる。SoW-Xは2025年5月下旬に米国で開催された国際学会ECTC 2025で同社が発表した論文から
FSRDLの配線層数はASICが6層、HBMが9層とかなり多い。
なおHBMは、「HBM4」以降の世代を想定している。
BSRDLの配線層数は信号用が5層、電源用が3層である。バックサイドRDLの信号用配線は長い距離(HBMの下をくぐってASIC間を結ぶ)を伝送するので、特性インピーダンスを90Ωに揃えるとともに差動伝送方式を採用した。
ローカルシリコンインターコネクトは3種類。1つは隣接するASIC間の接続用(D2D)、もう1つはASICとHBMの接続用(D2M)、3番目はシリコンキャパシタ兼TSV(Through Silicon Via)用である。
SoW-Xのフロアプラン。2025年5月下旬に米国で開催された国際学会ECTC 2025でTSMCが発表した論文から
PCIe接続のクラスタに比べ、消費電力当たりの性能は65%向上
1個のASICとその両隣に合計5個のHBMを配置したサブモジュール(基本ユニット)を4×4の行列状に配置し、SoW-Xのモジュールを構成した。モジュールのサイズは横方向(水平方向)が218mm、縦方向(垂直方向)が190mmである。レチクルサイズに換算すると約48倍となる。
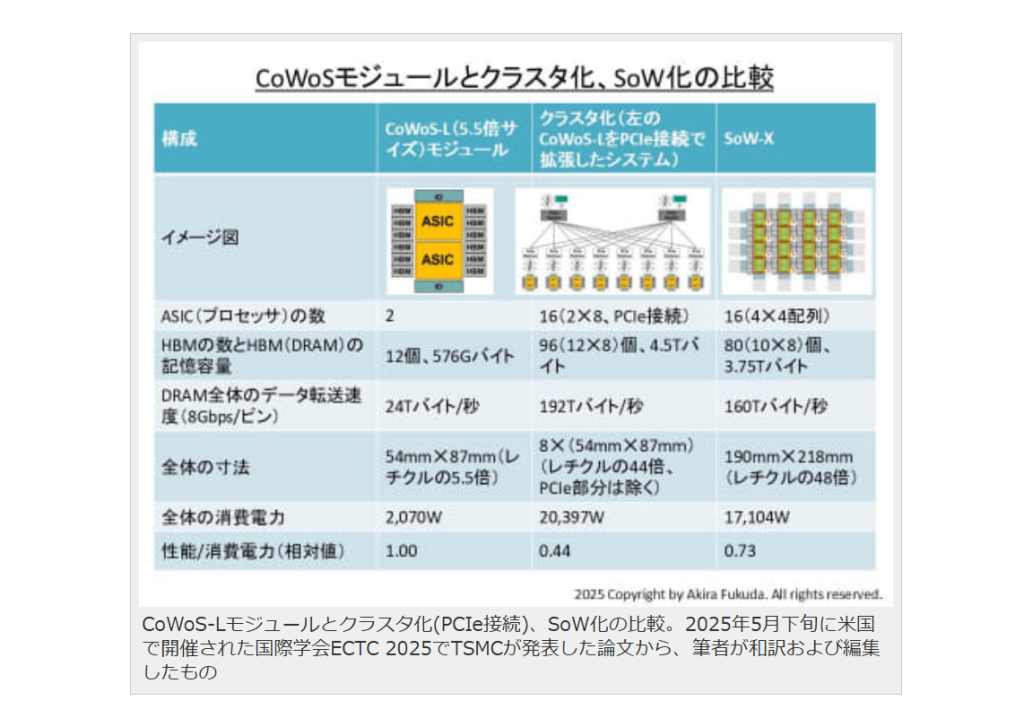
このSoW-Xを、レチクルサイズの5.5倍のCoWoS-Lモジュール(2個のASICと12個のHBMで構成)、および、8個のCoWoS-LモジュールをPCIe接続でクラスタ化したシステム(16個のASICと96個のHBMで構成)と比較した。
クラスタ化とSoW-X化で比較すると、消費電力当たりの性能はSoW-Xが約65%高い。ただしCoWoS-Lモジュール単体に比べると、消費電力当たりの性能は27%低下する。
なおSoW-X全体の消費電力は17kWに達する。水冷による放熱を想定しており、ECTC 2025ではその点についても言及していた。水冷方式の放熱プレートはASICおよびHBMの上に配置する。
CoWoS-Lモジュールとクラスタ化(PCIe接続)、SoW化の比較。2025年5月下旬に米国で開催された国際学会ECTC 2025でTSMCが発表した論文から、筆者が和訳および編集したもの
SoW-Xの実用化時期は2027年とされる。技術的に困難な課題は今のところあまりなく、高額と見られる製造コストを顧客が受け入れられるかどうかだろう。
問題はむしろ、この後だ。中間基板の寸法拡大による大規模化と高性能化は、ウェハサイズで限界に達したように見える。その先はパネルサイズなのか、ウェハ積層なのか、それとも別の手法なのか。行方を見守りたい。』
-
円売り呼んだ植田総裁2度目の「失言」 1ドル150円、広がる先安観
https://www.nikkei.com/article/DGXZQOUB31DHE0R30C25A7000000/『2025年8月1日 9:28 [会員限定記事]
think!
多様な観点からニュースを考える
小山賢太郎さん他2名の投稿
小山賢太郎竹中治堅滝田洋一外国為替市場で円安が再燃している。1日の東京市場で対ドルの円相場は一時1ドル=150円台に下落した。円売りにつながったのは日銀の植田和男総裁による「失言」だ。昨年4月以来となる円安を呼び込む発言を受け、市場では円の一段安を見込む声が増え始めている。
「不用意な発言だった。植田総裁は何をしたかったんだろうか」。ある市場参加者は記者会見を聞き終えたあとに首をかしげた。
「円安容認」と捉えた市場
日…この記事は会員限定です。登録すると続きをお読みいただけます。』
-
好機逃した人民元の国際化 たまる売りのマグマ
https://www.nikkei.com/article/DGXZQOUB11A0U0R10C25A7000000/

『2025年8月1日 5:00 [会員限定記事]
think!
多様な観点からニュースを考える
柯 隆さんの投稿
柯 隆「2国間の金融の潜在力を解き放つ」。中国人民銀行(中央銀行)とエジプト中央銀行は7月11日、金融協力の深化を目指す覚書(MOU)に調印した。同時に中国銀聯(ユニオンペイ)や、中国が立ちあげた独自の国際銀行間決済システム(CIPS)の活用についても推進することで合意した。
元が多くの国・地域で使われるのを目指す元の国際化。決済手段や決済網を広げ、世界に政治・外交的な影響力を強めようと、中国当局は今…
この記事は会員限定です。登録すると続きをお読みいただけます。』
-
『AI による概要
GDP(国内総生産)の三面等価性とは、生産、分配(所得)、支出の3つの側面から見たGDPの値が常に等しくなるという経済学の原則です。つまり、どれだけモノやサービスが生産されたか(生産面)、それらがどのように分配されたか(分配面)、そして誰がそれらを消費・投資したか(支出面)をそれぞれ計算しても、最終的な値は同じになるということです。
詳細:
生産面:
国全体の生産活動によって生み出された付加価値の合計を表します。
分配面:
生産された付加価値が、賃金、利潤、地代、税金などの形で、各経済主体に分配された所得の合計を表します。
支出面:
生産されたモノやサービスが、家計、企業、政府などによって消費、投資、輸出として支出された合計を表します。
これらの3つの側面からGDPを計算すると、理論上は同じ値になるという考え方が三面等価の原則です。
なぜ等しくなるのか?
例えば、企業が製品を生産すると、その生産額は企業所得や従業員の賃金として分配されます。そして、その所得は、家計によって消費されたり、企業によって投資されたりします。つまり、生産されたものは、必ず誰かの所得となり、そして誰かの支出となるため、三面は等しくなるのです。
三面等価の原則の意義:
経済活動の全体像を多角的に把握するのに役立ちます。
経済政策の効果を検証する際に、生産、分配、支出の各側面から分析することで、より的確な政策を立案するのに役立ちます。
経済の健全性を測る指標としても利用されます。
例:
もし、ある国の生産面でGDPが100兆円だった場合、分配面でも100兆円、支出面でも100兆円となるのが三面等価の原則です。
三面等価の原則|証券用語解説集 – 野村證券
一国の経済において、生産(付加価値)、分配(所得)、支出(需要)の3つの側面でみた額が、一定期間が経過した後(事後的)に…野村證券
GDPとその三面等価 | 夢ナビ講義 | 夢ナビ 大学教授がキミを学問の世界へナビゲート夢ナビ
三面等価の原則 中小企業診断士 経済学・経済政策 平成20年 第1問
GDP は、生産面、分配面、支出面の3 つの側面から見ることができます。 この3 つのGDP が等しくなるというのが「三…AI の回答には間違いが含まれている場合があります。 詳細』
-
悪いインフレ? 生活にも影響する「スタグフレーション」とは
https://www.nomura.co.jp/wealthstyle/article/0029/


『2022.03.24
ここ最近、「スタグフレーション」という経済用語を耳にする機会が増えたと感じている人は多いかもしれないが、その意味を説明できるだろうか。日本では長らくデフレーションが経済に与える影響を懸念されているが、スタグフレーションも同様に厄介で、私達の生活やビジネスに大きな影響を与える可能性がある。
スタグフレーションの概念や生活にどんな影響があるのかを知り、乗り切るための対策を考えてみよう。
スタグフレーションは「悪いインフレ」
スタグフレーションはインフレの一種だ。まずは、デフレーション(以下、デフレ)とインフレーション(以下、インフレ)について整理しておきたい。簡単にいえば、デフレは物価が継続的に下落する状態で、インフレは物価が継続的に上昇する状態のことをいう。
分かりやすい例として、カップ麺で考えてみよう。以前に150円で売っていたカップ麺が、デフレ時だと100円で購入できるなど、モノの値段が下がっていく。消費者は「値下がりが続くとお得だ」と感じるかもしれないが、次第にモノが売れずに不景気となる。そうすると企業業績の悪化や従業員の給与の減少などから人々の所得が減り、消費者は消費を控えるようになる。企業はさらに値下げをしなければ売れないという悪循環「デフレ・スパイラル」に陥ってしまうこともある。
一方、以前150円で売っていたカップ麺が200円になるなど、インフレ時はモノの値段が上がっていく。需要が供給を上回るときや原材料価格が上昇するときにインフレは起こりやすく、需要が増えると企業の生産活動が活発化するため、従業員の給料も上がるといった好循環を招きやすい。その結果、ゆるやかなインフレは、景気の安定化や拡大を促す傾向がある。
ここまでをまとめると、モノの値段が下がるデフレ時は景気が停滞しやすく、モノの値段が上がるインフレ時は景気が安定・拡大しやすいといえる。
では、本題のスタグフレーションについてだが、これは不況を意味するスタグネーションとインフレーションの合成語で、景気が停滞しているにもかかわらず、物価の上昇が続く現象を指す(図1)。
図1:スタグフレーションのイメージ
図1:スタグフレーションのイメージ通常、景気が停滞すると、需要が落ち込み、物価が下落していくデフレの状態になる。しかし、不景気の中で原材料価格などが上昇すると、給料は増えないにもかかわらず、物価の上昇が続く現象が起こることがある。これがスタグフレーションで、給料が同水準か減少傾向で推移する中、食料品やガス代などの生活必需品の価格が軒並み上昇してしまうと、私達の生活に影響が及んでしまうのだ。
2022年の現在は物価上昇中
近頃、さまざまなモノの値上がりを感じている人は多いのではないだろうか?
たとえば、大手パンメーカーは、2021年からの小麦粉の値上がりを受け、2022年1月1日出荷分から一部の食パン・菓子パンの値上げをした。また、電気代やガス代は燃料や原料の価格に合わせて上昇傾向にあるほか、同年3月下旬には大手製紙メーカーがトイレットペーパーなど家庭紙製品全品を値上げするなど、さまざまな商品の値上げが相次いでいる。
物価の変動を表す指数である「消費者物価指数」を見ても、2021年度から前年同月比で上向く傾向にある(図2)。給料が伸び悩む中、このまま生活必需品の価格が上昇し続ければ、スタグフレーションに近い状態になりかねない。図2:消費者物価指数の推移
図2:消費者物価指数の推移出典:総務省統計局「2020年基準 消費者物価指数 全国 2021年(令和3年)平均」をもとに編集部作成
日本はスタグフレーションを経験済み
物価の動きを観察するには、さまざまな製品の原料になる資源価格の値上がりに注目したい。中でも原油は、生活に欠かせないプラスチック製品やガソリンの原料になるため、原油価格の変動は暮らしや企業活動に大きな影響を及ぼす可能性がある。
過去を振り返ると、1970年代の第1次オイルショック後に日本はスタグフレーションを経験した。第1次オイルショックのきっかけは、1973年に勃発した第4次中東戦争で、石油輸出機構に加盟している中東の国々が原油の供給制限と輸出価格の大幅な引き上げを行い、国際原油価格が3カ月で約4倍に高騰。当時エネルギーの8割近くを輸入原油に頼っていた日本の社会は大きく混乱した。
その様子を当時のデータから見てみよう(図3)。消費者物価指数は、第4次中東戦争前の1972年には前年比4.9%上昇だったが、1973年は同11.7%上昇、1974年は同23.2%上昇している。一方、実質GDP成長率の推移を見ると、物価が急上昇する中、同時期に大きく落ち込んでいる様子が分かる。
図3:オイルショック時の消費者物価指数と実質GDP成長率の推移
図3:オイルショック時の消費者物価指数と実質GDP成長率の推移出典:総務省統計局「2020年基準 消費者物価指数 全国 2021年(令和3年)平均」、内閣府「令和3年度 年次経済財政報告」をもとに編集部作成
スタグフレーションに備えるためにやっておくべきこと
岸田内閣は、従業員の給与総額を増やした企業に、増加分の一定割合を税額控除する方針を示すなど、賃上げに取り組んでいる。こうした政策が奏功し、日本経済がコロナ禍から立ち直れば、インフレになってもスタグフレーションを防ぐことができるかもしれない。
しかし、もしものために、個人でもスタグフレーションに備えておくことは大切だ。具体的な方法はさまざま考えられるが、副業やサイドビジネスで収入源を増やすのは多忙なビジネスパーソンには難しいこともあるだろう。そのような時は、本業で給与を上げるためのビシネススキル向上を目指すと同時に、収入の一部を資産運用に充てて、早めに資産形成に取り組むことも考えておくべきではないだろうか。重要なことは、経済的なショックや不景気が来ても耐えられるようにしておくこと。この機会に、お金の使い方や資産のつくり方を考えておこう。』
-
『出典: フリー百科事典『ウィキペディア(Wikipedia)』
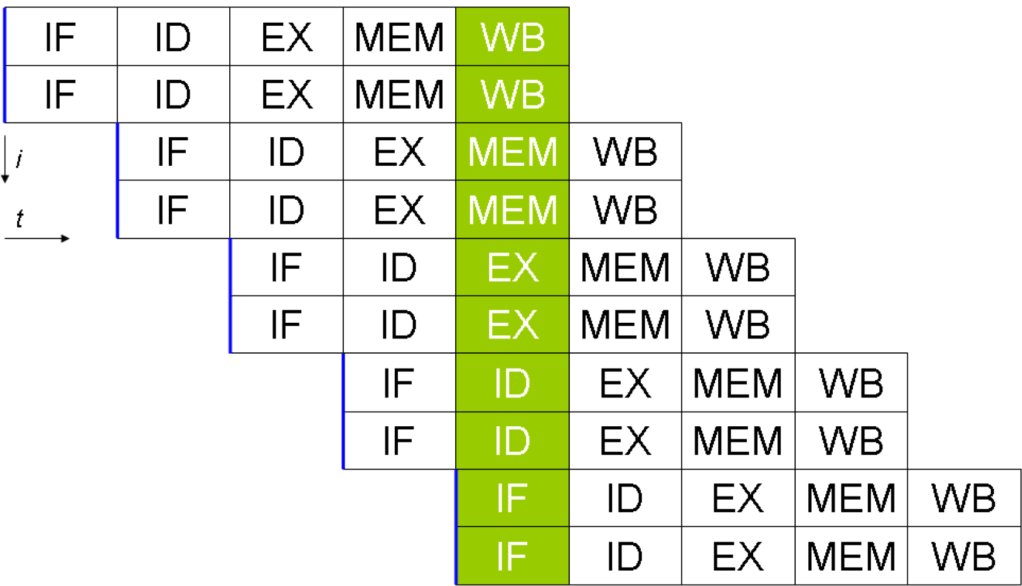
スーパースカラーのパイプライン概念図
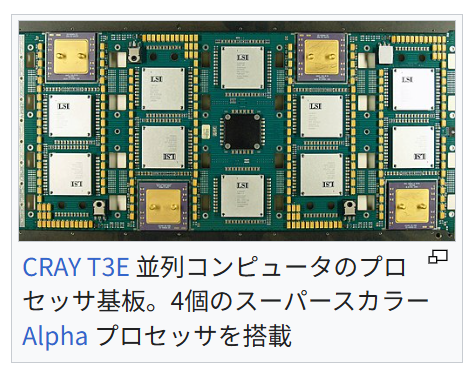
CRAY T3E 並列コンピュータのプロセッサ基板。4個のスーパースカラー Alpha プロセッサを搭載
スーパースカラー(superscalar,スーパースケーラ)とは、プロセッサのマイクロアーキテクチャにおける用語で、複数の命令を同時にフェッチし、複数の同種のあるいは異種の実行ユニットを並列に動作させ[1]、プログラムの持つ命令レベルの並列性を利用して性能の向上を図るアーキテクチャである。
概要
スーパースカラプロセッサは、単一のプロセッサ内で命令レベルの並列性と呼ばれる、ある一種の並列処理の形式を実装するCPUである。クロックサイクル毎に最大で1つの命令しか実行できないスカラプロセッサとは対照的に、スーパースカラプロセッサは、プロセッサ上の複数の異なる実行ユニットに複数の命令を同時にディスパッチすることにより、1クロックサイクル中に複数の命令を実行できる。したがって、既定のクロックレートで(普通)可能なスループットよりも多くのスループット(単位時間のうちに実行できる命令の数)が可能になる。各実行ユニットは、個別のプロセッサ(あるいはマルチコアプロセッサの場合個別のコア)ではなく、単一CPU内の算術論理演算ユニットなどのような実行リソースである。
歴史
1965年のシーモア・クレイが設計したCDC 6600が、最初のスーパースカラー設計のマシンと言われている。
商用のシングルチップのスーパースカラーマイクロプロセッサは、Intel i960CA(1988年)と AMD 29000シリーズの 29050 (1990年)が最初である。RISC型CPUの設計ではコアが単純であったため、当時の設計ルールの細かさでもワンチップに複数の実行ユニット(ALUなど)を搭載でき、スーパースカラーを実現できたのである。このため、1980年代から1990年代にかけての時期に RISC が CISC に対して性能的に優位に立った。一部の低消費電力の組み込み向けプロセッサを除いて、1998年以降に開発された汎用プロセッサは基本的に全てスーパースカラーである。
現在パーソナルコンピュータでデファクトスタンダードとなっているx86アーキテクチャでは、1993年のPentiumで2実行ユニットのインオーダ実行型のスーパースカラーを実現し、その後の”P6″(Pentium Pro と Pentium II)以降で3実行ユニットのアウトオブオーダ実行型スーパースカラーに発展した。2008年現在のIA-32アーキテクチャは単一コア当り5実行ユニットのアウトオブオーダ実行型スーパースカラーで、平均IPCは3以上を達成している。
スカラーからスーパースカラーへ
最も単純なプロセッサアーキテクチャをスカラープロセッサと呼ぶ。スカラープロセッサでは、各命令で1つか2つのデータを一度に扱う。一方、ベクタープロセッサでは同時に多数のデータを扱う。これは数学におけるスカラーとベクトルの違いに似ている。スーパースカラープロセッサはこれらの中間と言える。各命令は1つのデータを扱うが、CPU内に複数の実行ユニットがあるため、それぞれ別のデータを扱う複数の命令を同時並列的に実行可能となる。
スーパースカラーCPUの設計では、複数存在する実行ユニットを常に働かせておくために、命令の分配機構が重要である。実装される実行ユニット数が増えるにつれ、その重要性は増している。初期のスーパースカラー型CPUには、2つのALUと1つのFPUが搭載されていたが、最近の PowerPC 970 では4つのALUと2つのFPUと2つのSIMDユニットが搭載されている。分配機構が効率的でない場合、これらの実行ユニットに連続して命令を供給することができず、システムの性能は全体として低くなる。
スーパースカラープロセッサの実行効率はサイクル当たりの実行命令数で表される。ただし、サイクル当たりの実行命令数が大きいからといって、常にスーパースカラーだとは限らない。パイプライン型CPUやマルチコアCPUも同様の性能を示すが、方式は異なる。
スーパースカラー型CPUでは、分配機構がメモリから命令群を読み込み、そこから並列に実行できる命令を選択し、実行ユニット群にそれらを供給する。従って、スーパースカラープロセッサはパイプラインが複数あって、各パイプラインが1つの命令スレッドを実行していると見なすこともできる。
限界
スーパースカラー技法による性能向上は、以下の2つによって制限される。
命令列の本質的な並列性の度合い。つまり、命令レベルの並列性の制約。
命令間の依存関係チェックロジックと分配機構が命令選択にかけられる時間の制約と機構自体の複雑さ。
既存のバイナリの実行プログラムの持つ並列性にはばらつきがある。ものによっては命令間の依存が全く無く、常に並列に実行可能なこともある。逆に依存関係が多く、並列性がほとんどない場合もある。例えば、a = b + c; d = e + f という命令列は依存関係がないため、並列に実行可能である。しかし、a = b + c; b = e + f という命令列は依存関係があるため、並列に実行することはできない。
同時に実行可能な命令数が増えると、依存関係をチェックするコストも急激に増大する。また、そのチェックをCPUのクロックに合わせて実行時に行わなければならないという事実が事態をさらに悪化させる。研究によれば、命令の種類を n、同時実行可能な命令数を k としたとき、依存関係チェックの回路規模は
n
k
{\displaystyle n^{k}}、時間は
k
2
log
n
{\displaystyle k^{2}\log n} かかるとされている。数学的には、この問題は順列における組合せ数学の問題である。たとえ命令列に依存関係がないとしても、スーパースカラー型CPUは常に依存関係のチェックを行う。さもなくば、依存関係の検出に失敗し、不正な結果を得ることになる。
半導体プロセス技術がどれだけ進化して、スイッチ速度が高速化しても、以上のような問題によって同時に実行可能な実際の命令数には限界が生じる。プロセス技術の進化によって実行ユニット(ALUなど)の数が増えても、依存関係チェックのための論理回路の規模の増大が急激であるため、実現可能な規模は制限される。また、たとえ依存関係チェックを無限に素早く実行できたとしても、命令列の本質的な並列性によって性能向上に限界が生じる。
類似技法
このような限界があることから、他の性能向上技法の探求が行われた。例えば、VLIW、EPICアーキテクチャ、同時マルチスレッディング (SMT)、マルチコアなどである。
VLIW では、依存関係チェックを実行時にハードウェアで行うのではなく、コンパイラで行う。スーパースカラー設計では数ナノ秒で行わなければならないが、コンパイラではその制限はない。また、マルチコアとマルチスレッド・コンパイラの組合せでも同様である。EPICアーキテクチャも VLIW に似ている。
同時マルチスレッディング (SMT) はスーパースカラー型CPUの全体効率を向上させる技法である。SMT では複数の独立したスレッドを同時に実行することで、実行ユニットの稼働効率を向上させる。
マルチコアCPUは、個々のコアが1つのスレッドを実行する独立したプロセッサとなっている(通常、キャッシュを共有している)。
これらの技法は排他的なものではない。従って、マルチコアCPUの各コアがスーパースカラーであっても構わない。
脚注
^ “super-scalar organization in which multiple execution units operate essentially independently.” AMD. (2020). Software Optimization Guide for AMD EPYC™ 7003 Processors. rev. 3.00.
関連項目
アウト・オブ・オーダー実行
投機的実行/積極的実行
EPICアーキテクチャ
スーパーパイプライン
同時マルチスレッディング
パイプライン処理
参考文献出典は列挙するだけでなく、脚注などを用いてどの記述の情報源であるかを明記してください。 記事の信頼性向上にご協力をお願いいたします。(2023年1月)
マイク・ジョンソン著、村上和彰監訳、『スーパスカラ・プロセッサ- マイクロプロセッサ設計における定量的アプローチ -』、日経BP社、ISBN 4-8227-1002-5 (原著 Mike Johnson, Superscalar Microprocessor Design, Prentice-Hall, 1991, ISBN 0-13-875634-1)
Sorin Cotofana, Stamatis Vassiliadis, “On the Design Complexity of the Issue Logic of Superscalar Machines”, EUROMICRO 1998: 10277-10284
Steven McGeady, “The 1960CA SuperScalar Implementation of the 80960 Architecture”, IEEE 1990, pp. 232-240
Steven McGeady, et al., “Performance Enhancements in the Superscalar i960MM Embedded Microprocessor,” ACM Proceedings of the 1991 Conference on Computer Architecture (Compcon), 1991, pp. 4-7
外部リンク
Eager Execution / Dual Path / Multiple Path by Mark Smotherman
表話編歴
CPUテクノロジー
表話編歴
並列計算
カテゴリ: スーパースカラー・マイクロプロセッサコンピュータアーキテクチャCPU並列コンピューティング
最終更新 2025年5月18日 (日) 05:20 (日時は個人設定で未設定ならばUTC)。
テキストはクリエイティブ・コモンズ 表示-継承ライセンスのもとで利用できます。追加の条件が適用される場合があります。詳細については利用規約を参照してください。』 -
MIPSアーキテクチャ
https://ja.wikipedia.org/wiki/MIPS%E3%82%A2%E3%83%BC%E3%82%AD%E3%83%86%E3%82%AF%E3%83%81%E3%83%A3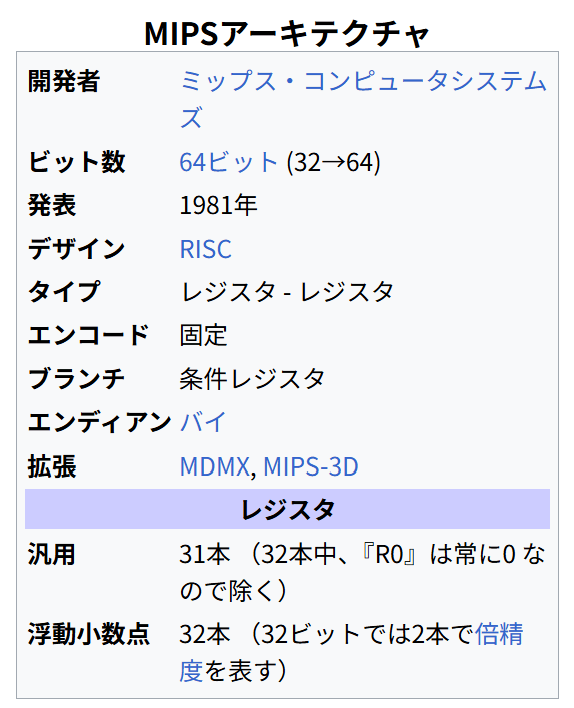

『出典: フリー百科事典『ウィキペディア(Wikipedia)』
MIPSアーキテクチャ
開発者 ミップス・コンピュータシステムズ
ビット数 64ビット (32→64)
発表 1981年
デザイン RISC
タイプ レジスタ – レジスタ
エンコード 固定
ブランチ 条件レジスタ
エンディアン バイ
拡張 MDMX, MIPS-3D
レジスタ
汎用 31本 (32本中、『R0』は常に0 なので除く)
浮動小数点 32本 (32ビットでは2本で倍精度を表す)MIPSアーキテクチャは、ミップス・コンピュータシステムズ(現ミップス・テクノロジーズ)が開発したRISCマイクロプロセッサの命令セット・アーキテクチャ (ISA) である。
概要
MIPSは “Microprocessor without Interlocked Pipeline Stages”((命令)パイプラインのステージに「インターロックされたステージ」がないマイクロプロセッサ)に由来しており、R2000の頃のマイクロアーキテクチャの特徴からの命名である(が、その後そのような特徴が薄れていったのも、他のRISCと同様である)。
MIPS値にも掛けている。
当初は32ビット幅のレジスタとデータバスを持つ32ビットの構成だったが、後に64ビットに拡張された。
MIPSアーキテクチャには下位互換のある複数の命令セットが存在する。
それぞれ、MIPS I、MIPS II、MIPS III、MIPS IV、MIPS 32、MIPS 64 と称する。
現行版は MIPS 32(32ビット実装)と MIPS 64(64ビット実装)である[1][2]。MIPS 32 と MIPS 64では命令セットだけでなく制御レジスタについても定義している。
いくつかのアドオン拡張も用意されている。
例えば、MIPS-3D は、3Dタスクで一般的な処理を行うための浮動小数点SIMD命令のシンプルなセットである[3]。
また、MDMX (MaDMaX) は、より広範な整数SIMD命令セットで、64ビット浮動小数点レジスタを流用する。
その他、MIPS16e は命令列を圧縮してプログラム格納域を小さくするための拡張である (ARMアーキテクチャのThumbエンコーディングに対抗したもの) [4]。
また、MIPS MT は、米インテル社がハイパースレッディング・テクノロジーとして普及させた技術と同等の、マルチスレッディングに適した拡張である[5]。
命令セットが非常にきれいなので、アメリカ合衆国ではコンピュータ・アーキテクチャを学校で教えるときに教材としてMIPSアーキテクチャを使うことが多い[6]。
MIPSのデザインは、もうひとつの初期のRISCであるバークレーRISC(en:Berkeley RISC)と共に、後発のRISCに影響を及ぼした。
MIPSプロセッサは、SGIのコンピュータ製品群に使われていた。
日本では、ソニーのNEWSや日本電気 (NEC) のEWS4800で使われた。
また、米DEC社は、ごく短期間だけMIPSを使ったワークステーションを製品化していた[注 1]。
また、機器組み込み分野で成功し、Windows CE製品、シスコシステムズのルーター、プリンタのエンジンなどに使われた。
ゲーム機分野でも成功を収め、NINTENDO 64、ソニー・コンピュータエンタテインメントのPlayStation、PlayStation 2、PlayStation Portable、PlayStation 3 (CECHA00/CECHB00 モデルのみ)でもMIPSアーキテクチャのプロセッサが使われた。
1990年代後半、RISCマイクロプロセッサの出荷個数ベースで3分の1がMIPSアーキテクチャの製品だったと見積もられている[7]。
歴史
RISCの先駆者
1981年、スタンフォード大学のジョン・L・ヘネシー率いるチームは、後に最初のMIPSプロセッサを生むプロジェクトを開始した。
基本コンセプトは、命令パイプラインを深くすることで劇的に性能を向上させることである。
IBM 801 などの研究や先例でこの手法はよく知られていたが、その可能性が完全に解明されていなかった。
一般にプロセッサは、命令デコーダ、演算論理装置 (ALU)、メモリとやりとりするロード/ストア・ユニットといった部分で構成されている。
パイプライン化されていない従来の「マイクロプロセッサの」設計では、1つの命令の処理を(ほぼ)完了させないと次の命令の処理を開始できず、内部ではほとんどの時間を処理に関与せずに待機するだけの回路が多くなる。
これに対して「従来のマイクロプロセッサ」ではない、例えば1960年代のIBM 7030の頃には実現されていた命令パイプライン方式では、1つの命令の処理過程を複数のステージ(段階)に分割し、各ステージを順次、次のサブユニットに送って、複数のサブユニットがオーバラップして動作できるようにする。
1つ目の命令の最初のステージの処理が終わると、次のステージの処理へ引き継がれると同時に、2つ目の命令の最初のステージの処理が平行して実行される。
3つ目の命令が入ると1つ目の命令は3ステージ先、2つ目の命令は2ステージ先、3つ目の命令は最初のステージで、3つの処理が同時に行われる。
すべてが最も効率的に動けば、複数に分割した処理過程の内容に関わらず、1ステージの処理ごとに1つの命令が完了できることになる。
命令パイプラインでは、乗算・除算命令のように命令の実行に長い時間がかかる場合、パイプラインに次の命令を取り込むのを待つ必要がある。
この問題の解決策として、パイプラインの各ステージが処理中であることを示せるようにして、パイプラインをインターロックして、次の命令のステージが進行しないように止めなければならない。
これがストールである。
分岐命令を実行すると、後続の命令が途中のステージまで進行していたものを取り消さなければならず、ストールに加えて無駄となった処理時間分も加わる。
これらがインターロックのロスとなる[8]。
ストールが発生しインターロックがかかると命令パイプラインは足踏みするため、性能向上は望めないと考えられていた。
MIPSの設計上では、すべての命令を単純化して実行処理が1クロックサイクル内で完了するよう計画された。そうできればインターロックをなくすことができる。
このような設計にすることで掛け算や割り算などの複雑な命令が1つの命令では実行できなくなるが、単純な命令だけであれば、プロセッサに与えるクロックを高速にでき早く動作させて、性能が向上すると予想された。
また、インターロック回路を加えると半導体チップの面積(ダイサイズ)が増えて、クロックを上げることが困難になるため、クロックの高速化のためにはインターロックを排除することも必要だった。
複雑だが有用だった命令を排除することは議論の中心になった。
多くの人が「複雑な掛け算を単純な多くの足し算にして、どうして速度が向上するのか」と、この設計手法、そしてRISC一般の謳い文句に懐疑的で誇大広告だと言った。
しかし、これらの意見は、この設計における速度向上のポイントが命令の機能にあるのではなく、パイプラインにあるということを無視したものだった。
時間のかかる処理にまつわる問題は、ディレイスロットで一応解決された。
例えば、2クロックサイクルかかる命令があった場合、次の命令をディレイスロットとし、そこに、前の命令と依存関係の無い、つまり前の命令の結果を必要とせず、かつ前の命令に関わっているレジスタを使用しない命令を配置することで、パイプラインを止めないようにした。
これを実現するためには、プロセッサに与える命令列を生成するコンパイラが、あらかじめ各命令ごとのクロックサイクル数を把握して、可能な限りディレイスロットを有効な命令で埋めるようにする必要があった。
それでも大部分の命令は1クロックサイクルで実行できた。
また、コンパイラ技術の進展はディレイスロットの活用頻度を向上させた。
初期のMIPSと並び、RISCの典型であり代表とされるバークレーRISC(英語版)(SPARCへの影響が大きい)と比べると、サブルーチンコールの扱い方が大きく異なる。
バークレーRISCは頻繁に実行され性能への影響が大きいサブルーチンコールの性能向上を図るために、大きなレジスタファイルを持つと同時にレジスタ・ウィンドウというメカニズムを導入したが、それによってサブルーチンコールの入れ子段数が制限されている。
サブルーチンコールは、それぞれのルーチンで専用に用いるローカルのレジスタ群を必要とし、その割り当てをハードウェアでサポートするということはチップにさらなるリソースを必要とし、設計も複雑化することを意味する。
ヘネシーは、賢いコンパイラであればハードウェアでの実装に頼らずに使っていないレジスタを見つけ出すことができ、単にレジスタを有効利用できるだけでなく、あらゆるタスクの性能向上にも寄与すると考えた。
MIPSは最も典型的なRISCのひとつだとされる、というよりも、RISCの提唱者であるヘネシーとパターソンのそれぞれが設計した命令セット(命令セットアーキテクチャ)であるということを理由に、MIPSとバークレーRISCの設計が「典型的なRISC」だとされ、それらの特徴を以て「RISCの定義」だとされているためであり、「MIPSは最も典型的なRISC」だという言明はその逆になっている。
命令語のビット数を節約するために、命令数を抑えることで、命令フォーマット中のオペコード部として必要となるビット数を抑えている。
基本オペコードは、命令語32ビットの中の6ビットを使用し[9]、残りの部分の構成の違いにより数種類の分類がある。
命令語の残りの26ビットの部分について、26ビットの分岐先アドレスとする命令フォーマット、5ビットのフィールド4個で3つのレジスタとシフト値を指定し、残り6ビットを追加のオペコードとする命令フォーマット、2つのレジスタと16ビットの即値を指定する命令フォーマットがある。
このような設計で、実行すべき命令と必要なデータ(オペランド)を1サイクルでロードできるようになった
(正確には、必要なデータはレジスタの中にあるのであり、もし1サイクルで全てを揃えたいのなら特殊な技法が必要になる。
細かく言うと、「オペコードとオペランド指定子」を(1サイクルで32ビットをメモリからロードできるように他の部分が設計されていば)1サイクルでロードできる)。
最初のハードウェア
1984年、ヘネシーは、将来商業レベルとなる可能性のあるデザインを確立し、教え子、友人らとミップス・コンピュータシステムズを設立する。
1985年、彼らは、最初のデザインであるR2000を完成させた。
また、1988年には、それを進化させたR3000を完成させた。
これらの32ビットCPUによって、ミップス・コンピュータシステムズは、1980年代に基盤を築くことができた。
なお、これらの商用デザインにおいては、スタンフォード大学での学術研究的な設計方針とは異なり、ハードウェアにインターロック機構を装備し、掛け算も割り算もサポートしていた。
なぜなら、単にひとつのプログラムを実行するだけなら、上述のディレイスロットの考え方で何とかなるが、商用としてはマルチタスクや割り込みへの対応は必須であり、インターロック機構の付加は必然だったからである。
また、半導体プロセス技術の急速な進歩がそれを可能にしていった。
インターロック機構を備えたとしても、インターロックをなるべく発生させないコンパイラ技術は高速化に必須である。
これらのプロセッサは、SGI、DEC DECstation、ソニー NEWS、NEC EWS4800などに使われた。
これらの設計にはソフトウェアアーキテクトのアール・キリアンも参加している。
彼は後に MIPS III 64ビット命令セットを設計し、R4000のマイクロアーキテクチャ開発にも関わった[10][11]。
1991年、ミップス・コンピュータシステムズ社は、最初の64ビットマイクロプロセッサR4000をリリースした[注 2][8]。
R4000は仮想アドレスだけでなく仮想空間IDを格納できる進んだTLBを採用していた。
それによって頻繁なコンテキストスイッチの度にTLBをフラッシュする必要性をなくし、他の競合するアーキテクチャ(Pentium、PowerPC、Alpha)に対して劣っていたマイクロカーネル実装時の大きな性能問題を低減させることができた[12]。
しかし、ミップス社は、R4000を市場に提供しようとしたころ、財政危機に陥った。
そこで、当時のミップス社の最大の顧客であった米SGI社は、1992年にミップス社を買い取り、これによりMIPSアーキテクチャの存続が保証された。
こうしてミップス・コンピュータシステムズ社はSGIの子会社となり、社名もミップス・テクノロジーズと変更された。
アーキテクチャのライセンス供与
1990年初頭、ミップス・テクノロジーズ社は、プロセッサの設計をサードパーティーにライセンス供与しはじめた。
プロセッサ・コア、つまり主要な演算部分の単純さによって、これは「MIPSコア」として成功を収め、従来は同等のゲート数と価格のCISCプロセッサが占めていた様々な分野でMIPSコアが使われるようになった。
ゲート数と価格は密接な関係があり、CPUの価格はキャッシュメモリ領域を除けば、ゲート数とピン数でほぼ決まっていた。
サン・マイクロシステムズも追随してSPARCコアのライセンス供与を開始したが、成功したとは言い難い。
1990年代後半にはMIPSは機器組み込み用プロセッサ分野の勝者となっていた。
1997年、4800万個目のMIPSベースのチップが出荷され、MIPS CPUファミリはモトローラのMC68000ファミリを出荷個数で抜いた。
この成功により、SGI社はミップス・テクノロジーズを1998年にスピンオフさせた。
ミップス・テクノロジーズの収入の半分はライセンス料であり、残りはサードパーティーが生産するコアの設計から来ている。
1999年、ミップス・テクノロジーズ社はライセンス体系を整理し、32ビットのMIPS32(MIPS II にそれ以降の新規機能を追加したものだが、後に遅延分岐系のbranch likely は強い非推奨となり、将来の削除が予告された[13])と64ビットのMIPS64(MIPS V ベース)に分けた。
このアナウンスと同時に、NEC、東芝、SiByte(後にブロードコムが買収)がMIPS64のライセンス供与を受けた。
フィリップス、LSIロジック、IDTもすでに参加している。
成功に成功が続き、MIPSはコンピュータに近い機器(ハンドヘルドコンピュータやセットトップボックスなど)の市場で最も使われているヘビー級CPUコアとなっている。
モトローラ社もセットトップボックスに自社のPowerPCではなくMIPSコアを採用した。
いくつかのベンチャー企業もミップス・テクノロジーズ社よりアーキテクチャ・ライセンスの供与を受けて参入してきた。
最初にMIPSプロセッサを設計したベンチャー企業はQuantum Effect Devicesだった。
MIPS社でR4300iを設計したチームはSandCraft(英語版)社を設立し、NEC向けにR5432を設計し、後にSR7100を作った。
これは、組み込み分野向けの最初のアウト・オブ・オーダー実行プロセッサである。
DECで最初にStrongARMを設計したチームはふたつのMIPS関連ベンチャーを設立した。
ひとつはSiByteでSB-1250というMIPSベースで最初のSystem-on-a-chip (SOC) を実現した製品を作った。
もうひとつのAlchemy SemiconductorはAu-1000という低電力のSOCを作った。
SiByteはブロードコムに買収された。
AlchemyはAMDに買収されたが、後にAMDはAlchemyをRaza Microelectronics (RMI) に売却した。
LexraはMIPSに似たアーキテクチャをベースにDSP機能を付加したチップをオーディオ機器市場向けに、マルチスレッド機能を付加したチップをネットワーク機器市場向けに出している。
LexraはMIPSからライセンス供与を受けていなかったため、MIPSとの間で2件の訴訟となった。
1件はLexraがMIPS互換であることを宣伝しないという条件ですぐさま解決した。
2件目は長引き、両社を疲弊させた。結局、ミップス・テクノロジーズがLexraに対してフリーライセンスと賠償金を払うことで決着した。
MIPSアーキテクチャを使ったマルチコアデバイスを構築することに特化した企業も2社登場している。
Raza Microelectronics, Inc. は低迷していたSandCraftから製品ラインを買い取り、通信およびネットワーク市場向けに8コアの製品を提供した。
Cavium Networks は元々はセキュリティ・プロセッサのベンダーだったが、こちらも同じ市場向けに8CPUコアを集積したデバイスを開発し、後に最大32コア版を開発している。両社ともに社内でコアを設計しており、MIPSからコア設計を買うのではなくアーキテクチャのライセンス供与だけを受けている。
デスクトップ市場を失う
MIPSプロセッサを使ったワークステーションシステムを製造していた企業として、SGI、ミップス・コンピュータシステムズ、Whitechapel Workstations、オリベッティ、Siemens-Nixdorf、エイサー、DEC、NEC、ソニー、DeskStation があった。
またMIPSアーキテクチャ上に移植されたオペレーティングシステムとして、SGIのIRIX、マイクロソフトのWindows NT(v4.0まで)、Windows CE、Linux、BSD、UNIX System V、QNX、ミップス自身のRISC/osなどがある。
1990年代初頭、インテルプロセッサベースのPCに対抗してMIPSプロセッサベースのコンピューティング環境を作るために、コンパック他多数の企業によって Advanced Computing Environment (ACE) というコンソーシアムが設立された。
当時、MIPSなどの強力なRISCプロセッサがインテルのIA-32アーキテクチャに取って代わるだろうという予測がなされていた。
マイクロソフトの Windows NT が当初、Alpha、MIPS、PowerPCなどのRISCアーキテクチャに対応したこともその予測を裏付ける形となった。
しかしインテルがPentiumクラスのCPUをリリースすると、マイクロソフトの Windows NT v4.0 では対応するアーキテクチャをIA-32とAlphaのみに絞った。
後にSGIがItaniumやIA-32アーキテクチャへの移行を決定すると、デスクトップ市場ではMIPSプロセッサはほぼ完全に姿を消した[14]。
組み込み市場
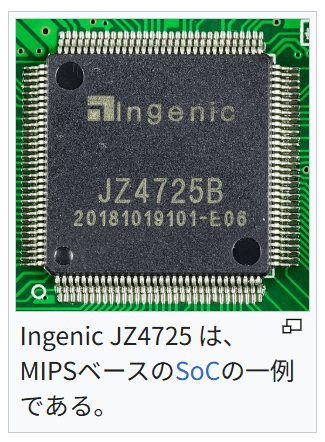
Ingenic JZ4725 は、MIPSベースのSoCの一例である。
1990年代を通して、MIPSアーキテクチャはコンピュータネットワーク、電気通信、アーケードゲーム、ゲーム機、プリンター、デジタルセットトップボックス、デジタルテレビ、DSLモデムやケーブルモデム、携帯情報端末といった組み込み市場で広く採用された。
MIPSの組み込み向け実装は低消費電力と低発熱を特徴とし、組み込み向けの開発ツールも充実しており、知識の蓄積もあることから、今も組み込み市場で人気を保っている。
組み込み市場向けの合成可能なコア
最近ではMIPSアーキテクチャはIPコアとして、組み込み用プロセッサの設計に使える形で利用されることが多い。
1999年の時点で、32ビットと64ビットの基本コアが提供されており、それぞれ MIPS32 4K と MIPS64 5K と呼ばれている。
それらのコアとFPU、SIMDシステム、各種I/Oデバイスなどを組み合わせてチップを設計できる。
MIPSコアは商業的に成功を収め、様々な機器で利用されている。
例えば、シスコシステムズやリンクシスなどのルーター、ケーブルモデム、ADSLモデム、ICカード、レーザープリンター、セットトップボックス、ロボット、ソニー・コンピュータエンタテインメントのPlayStation 2やPlayStation Portableなどで使われている。
携帯電話やPDAの分野では競合するARMアーキテクチャの座を奪うことはできなかった。
MIPSアーキテクチャの組み込み用プロセッサとして
IDT RC32438
ATI Xilleon
Alchemy Au1000/1100/1200
Broadcom Sentry5
RMI XLR7xx
Cavium Octeon CN30xx/CN31xx/CN36xx/CN38xx/CN5xxx
インフィニオン・テクノロジーズ EasyPort/Amazon/Danube/ADM5120/WildPass/INCA-IP/INCA-IP2
Microchip Technology PIC32
NEC EMMA/EMMA2/VR4181A/VR4121/VR4122/VR4181A/VR5432/VR5500
Oak Technologies Generation
PMC-Sierra RM11200
QuickLogic QuickMIPS ESP
東芝 Donau/TMPR492x/TX4925/TX9956/TX7901などがある。
映像組み込みでの利用
2008年の時点で、MIPSはデジタルテレビで68%、DVDレコーダーで72%、Blu-Rayレコーダーで77%、ケーブルテレビのセットトップボックスで70%、IPテレビのセットトップボックスで77%のシェアがあり、動画のデコーダ・エンコーダを必要とする映像関係で広く使われている[15]。
MIPSベースのスーパーコンピュータ
MIPSアーキテクチャは超並列型のスーパーコンピュータにも採用された。
シリコングラフィックス (SGI) は1990年代前半からデスクトップ型のグラフィックス・ワークステーションだけでなく高性能計算市場にも注力するようになった。
R4400やR8000を使った Challenge シリーズというサーバシステムで成功を収め、後にR10000も採用している。
その後SGIはさらに強力なシステムの開発に注力するようになる。
R10000を採用した Origin 2000 はNUMA型で最大1024個のプロセッサを相互接続するものだった。
さらにそこからR14000やR16000を最大1024個構成できる Origin 3000 を開発。
しかし、SGIは2005年にIA-64アーキテクチャへの移行を決定し、MIPSベースのスーパーコンピュータの開発をやめた。
高性能計算のベンチャー企業SiCortexは、2007年にMIPSベースの超並列マシンを発表した。
MIPS64アーキテクチャをベースとし、カウツグラフのトポロジーを使って高性能インターコネクトでノードを相互接続する。
消費電力が小さく計算能力が高い。
計算ノードはMIPS64コアを8個集積したマルチコアであり、メモリコントローラ、DMAエンジン、ギガビット・イーサネット、PCI Express コントローラなどがシングルチップに集積されていて、消費電力はわずか10ワットでありながら、浮動小数点演算性能はピークで6GFLOPSとされている。
最大構成のSC5832はそのようなノードチップ972個で構成されており、MIPS64コアが5832個ある。ピーク性能は8.2テラFLOPSとされている。
龍芯
→詳細は「龍芯」を参照龍芯は中国科学院が設計したMIPS互換のマイクロプロセッサであるが、当初はミップス・テクノロジーよりライセンスを受けていなかった。
そのマイクロアーキテクチャは中国が独自に設計したもので、初期の設計ではMIPSアーキテクチャにある4つの命令が実装されていなかった[16]。
2009年6月、中国科学院はミップス・テクノロジーズから直接、MIPS32およびMIPS64アーキテクチャのライセンス供与を受けた[17]。
2006年から各社が龍芯をベースとしたコンピュータをリリースしており、低消費電力のネットブックやネットトップもある[18][19]。
MIPS IV
MIPS IV は4番目のアーキテクチャである。MIPS III のスーパーセットであり、それまでの全てのアーキテクチャと互換性がある。MIPS IV は1994年のR8000で初めて実装された。MIPS IV で追加された点は次の通りである。
浮動小数点数のロード/ストア命令で「レジスタ + レジスタ」形式(インデックスつき)のアドレス指定を追加
単精度および倍精度の浮動小数点数の積和演算命令を追加
条件転送命令(整数レジスタと浮動小数点レジスタ)を追加
FPUの制御/ステータスレジスタに新たな条件ビットを追加し、全部で8ビットとした。
MIPS V
MIPS V は5番目のアーキテクチャで、1996年10月21日の Microprocessor Forum 1996 で発表された[20]。
主に3次元グラフィックスの性能向上を目的としている。
1990年代中ごろ、組み込み用途以外では主にSGIがグラフィックス・ワークステーションにMIPSマイクロプロセッサを使っていたためである。
MIPS V と同時にそれを補完する MIPS Digital Media Extensions (MDMX) というマルチメディア拡張(整数のみ)も発表された[21]。
MIPS V を実装した製品は結局登場しなかった。
1997年、SGIはコード名 “H1” または “Beast” と、”H2″ または “Capitan” というマイクロプロセッサを発表した。
前者は最初の MIPS V 実装で、1999年に出荷予定とされた。
“H1” と “H2” のプロジェクトは後に統合され、最終的に1998年に中止となった。
MIPS V は pair-single (PS) と呼ばれる新たなデータ型を追加していた。
これは単精度(32ビット)浮動小数点数のペアを64ビットのFPUレジスタに格納するものである。
算術演算命令、比較命令、条件転送命令ではPSデータをSIMD風に扱う。
またPSデータのロード、配置変更、変換などの命令が追加されている。
既存リソースで浮動小数点SIMDを実現しようという試みだった[21]。
MIPS CPU ファミリ
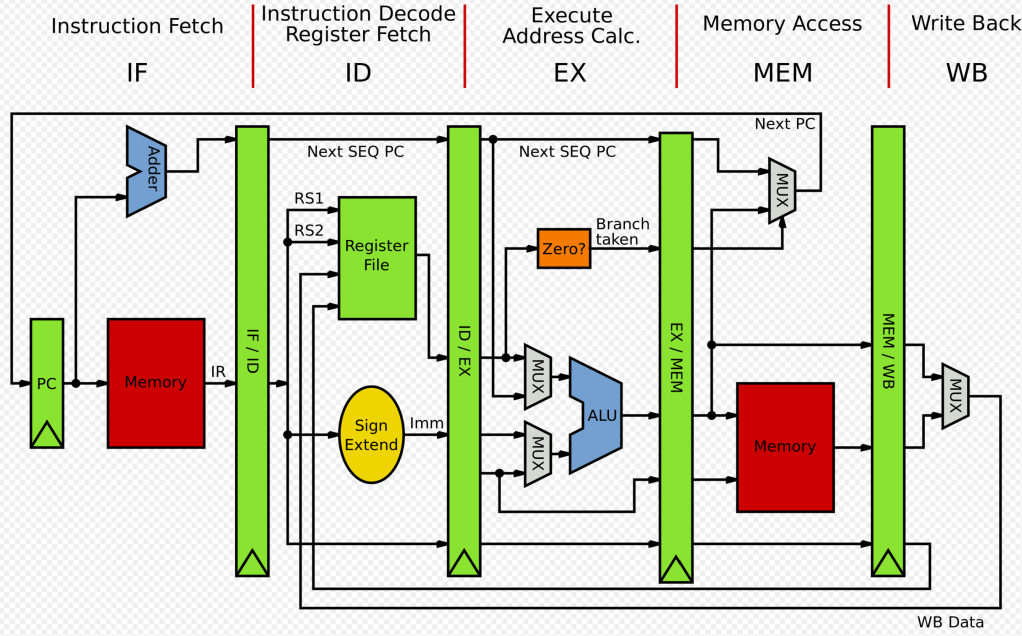
初期のMIPSのパイプライン概念図。5段パイプラインである(命令フェッチ、命令デコード、実行、メモリアクセス、ライトバック)
初の商用モデルR2000は1985年に発表された。
実行に複数サイクルを要する乗算と除算命令の処理部をチップ上にやや独立したユニットとして追加した。
乗除算の結果は直接汎用レジスタには入らず、専用のレジスタに出力されるため、それを汎用レジスタに持ってくる命令も追加された。
その命令を乗除算の完了前に発行するとパイプラインがインターロックする。
R2000は起動時にビッグエンディアンとリトルエンディアンのどちらかを選んで動作する。
32ビット汎用レジスタを32本持つが、コンディションコードレジスタを持たない。
設計者はそれがボトルネックになる可能性を考慮したためで、条件判断は指定した2つのレジスタの値の比較を行い、その結果で分岐の可否を判断する。
レジスタに入っている値で条件判断するのはAMD Am29000 や DEC Alpha とよく似ている。
なお、プログラムカウンタには直接アクセスできない。
R2000は最大4個のコプロセッサをサポートしており、そのうち1つは主CPUに組み込まれていて、例外処理、トラップ処理、メモリ管理などを行う。
したがって、実際に外付けできるコプロセッサは3個までである。
オプションの R2010 FPUをコプロセッサとして接続できる。
R2010は32ビットの浮動小数点レジスタを32本持ち、倍精度演算では64ビットレジスタ16本として使用できる。
R2000の後継としてR3000が1988年に登場した。
命令およびデータ向けにそれぞれ32KB(間もなく64KBに拡大)のキャッシュを追加し、マルチプロセッシングのためのキャッシュコヒーレンシにも配慮していた。
そのマルチプロセッササポートには欠陥があったが、R3000で何とかマルチプロセッサ構成にした製品がいくつか存在した。
R3000には当時の他のマイクロプロセッサと同様にメモリ管理ユニット (MMU) も組み込まれていた。
R3000にもR2000のときと同様に R3010 FPUが存在した。
MIPSアーキテクチャのプロセッサとしては初めて市場で成功を収め、累計100万個以上が生産された。
改良によって最高40MHzで動作するR3000Aが登場し、32VUPs (VAX Unit of Performance)の性能を発揮した。
R3000A互換の R3051 はソニー・コンピュータエンタテインメントのPlayStationに採用され、33.8688MHzで動作した。
サードパーティはR3000AとR3010をワンチップ化したものを設計しており、Performance Semiconductor のPR3400、IDTのR3500、NECのVR3600がある。
東芝のTX3900はSoCであり、Windows CE の動作するハンドヘルドPC向けに開発された。
航空宇宙分野向けに電磁波耐性を強化したMongoose-VもR3000とR3010をワンチップ化していた。
R4000シリーズは1991年に登場した。
命令セットを完全な64ビット対応に拡張し、FPUをCPUチップに統合し、従来よりずっと高いクロック周波数で動作した(当初は100MHz)。
しかし、クロック周波数を上げるために一次キャッシュは命令とデータそれぞれ8KBに減らされ、キャッシュアクセスに3サイクルかかるようになった。
動作周波数を上げるため、スーパーパイプラインと呼ばれるパイプライン段数を増やす工夫を行っている。
改良版のR4400は1993年に登場。一次キャッシュが16KBに倍増され、64ビット関連のバグ(エラッタ)が一掃され、より大きな二次キャッシュをサポートしている。
SGIの一部門となったミップスは外部バスを32ビットに縮小した低価格のR4200を設計し、さらに安価なR4300iのベースとなった。
R4300iをベースとしてNECが開発したVR4300はゲーム機のNINTENDO 64に採用された[22]。
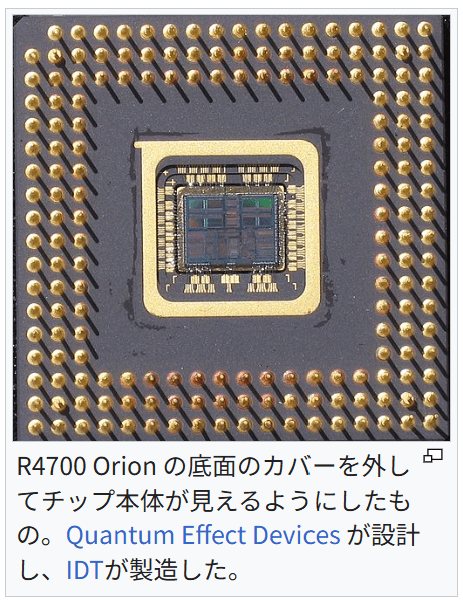
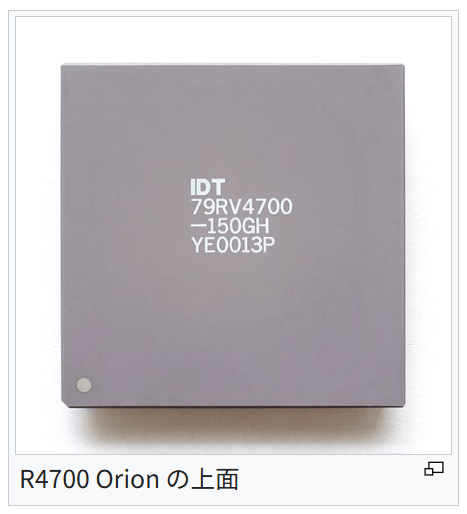
R4700 Orion の底面のカバーを外してチップ本体が見えるようにしたもの。Quantum Effect Devices が設計し、IDTが製造した。R4700 Orion の上面
ミップスの元従業員が創業した Quantum Effect Devices (QED) は、R4600 Orion、R4700 Orion、R4650、R5000を設計した。
R4000がクロック周波数を上げるためにキャッシュ容量を犠牲にしたのに対して、QEDは2サイクルでアクセスできる大きなキャッシュを搭載し、シリコンの面積の効率的利用を達成した。
R4600とR4700は SGI Indy の低価格版で採用され、シスコのルーター(36×0、7×00など)でもMIPSアーキテクチャとして初めて採用された。
R4650はWebTVのセットトップボックスで採用された。
R5000は単精度浮動小数点演算性能を向上させており、同クロック周波数のR4400を搭載した同型機(SGI Indy)よりもグラフィックス描画が高速になった。
SGIは同じグラフィックスボードでもR5000向けは名称を変更し、性能が高いことを強調した。
QEDはその後、ネットワーク機器やレーザープリンターなどの組み込み市場向けにRM7000とRM9000というファミリーを設計した[23]。
RM7000は256KBの二次キャッシュをチップ上に搭載し、三次キャッシュのコントローラも備えていた。
RM9xx0はSOCファミリーで、CPUにメモリコントローラ、PCIコントローラ、ギガビット・イーサネットのコントローラ、HyperTransportポートなどの高速I/Oといったノースブリッジ機能を集積している。
QEDは2000年8月、半導体企業 PMC-Sierra に買収され、PMC-SierraがMIPSアーキテクチャのプロセッサ開発を継続している。
R8000(1994年)はミップスの設計による初のスーパースケーラ方式で、複数の命令を同時に実行可能となった。
ワンチップではなく、CPU+一次キャッシュ(命令・データそれぞれ16KB)、FPU、二次キャッシュのタグRAMチップ×3(2個はキャッシュアクセス用、1つはバススヌープ用)、キャッシュコントローラの6個のチップで構成されている。
完全にパイプライン化された加算・乗算ユニットを2つ持ち、外付けの4MBの二次キャッシュからFPUが直接データを取ってくる設計である。
SGIの POWER Challenge サーバで採用され、後に POWER Indigo2 ワークステーションでも採用された。
しかし浮動小数点演算性能は高いが整数演算性能はあまり高くないため科学技術計算などにしか向かず、また複数チップで構成されるためコストが高く、SGI以外では採用例がない。
1995年R10000がリリースされた。
シングルチップでR8000よりも高いクロック周波数で動作し、一次キャッシュは命令・データ共に32KBと大きい。
スーパースケーラ設計だが、最大の改良点はアウト・オブ・オーダー実行を採用した点である。メモリ・パイプラインは1つしかなく、FPUもR8000より単純だが、整数演算性能が大幅に強化されており、低コストでもあったため、市場で成功を収めた。
その後の設計は全てR10000コアをベースとしている。R12000は0.25μmプロセスを採用してチップを縮小し、クロック周波数を高めている。それを改良したR14000でもクロック周波数を向上させると共に、外付けの二次キャッシュに DDR SRAM を利用可能にした。その後もクロック周波数を向上させ内蔵キャッシュ容量を増加させたR16000とR16000Aがリリースされた。
他にもMIPSファミリーにはR6000(1991年)がある。ECLで実装したもので、Bipolar Integrated Technology が製造した。R6000では MIPS II 命令セットが初めて採用された。TLBとキャッシュのアーキテクチャが他のMIPSファミリーとは大きく異なる。発表したとおりの性能を発揮できなかったが、CDCがサーバに採用した。しかし、すぐに市場から姿を消した。
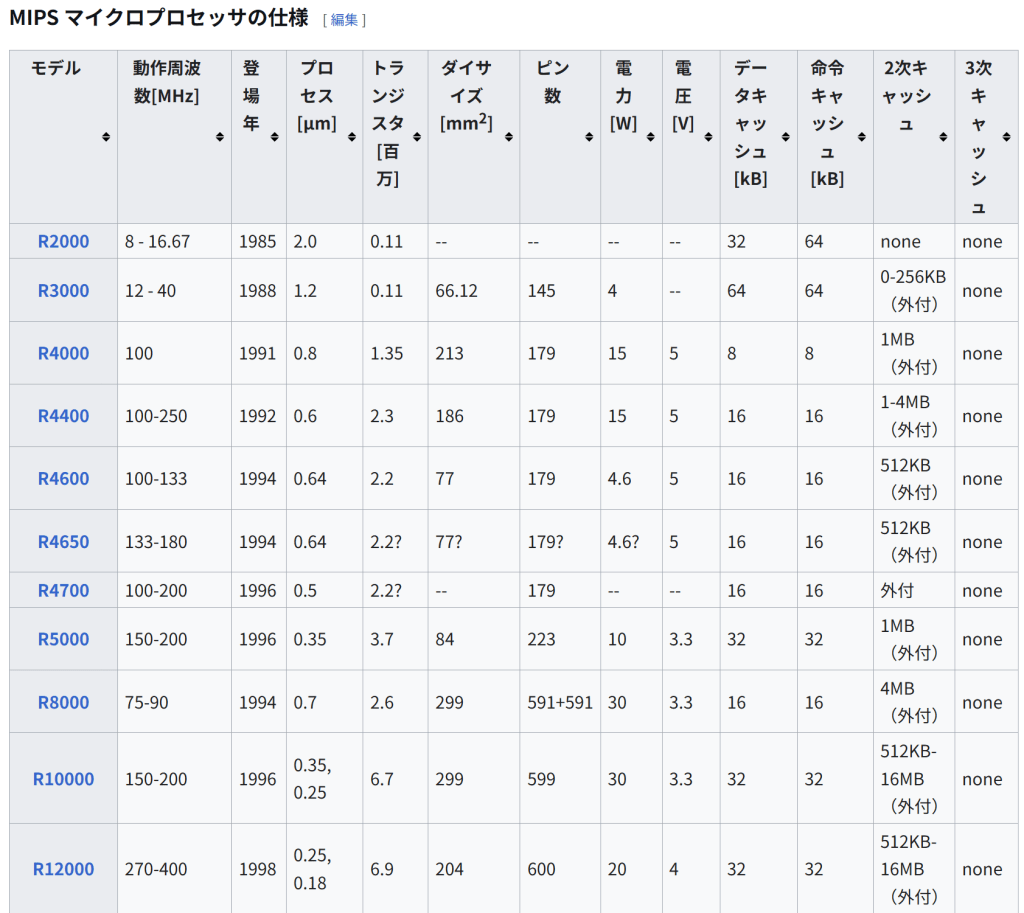
MIPS マイクロプロセッサの仕様
モデル 動作周波数[MHz] 登場年 プロセス[μm] トランジスタ[百万] ダイサイズ[mm2] ピン数 電力[W] 電圧[V] データキャッシュ[kB] 命令キャッシュ[kB] 2次キャッシュ 3次キャッシュ
R2000 8 – 16.67 1985 2.0 0.11 — — — — 32 64 none none
R3000 12 – 40 1988 1.2 0.11 66.12 145 4 — 64 64 0-256KB (外付) none
R4000 100 1991 0.8 1.35 213 179 15 5 8 8 1MB (外付) none
R4400 100-250 1992 0.6 2.3 186 179 15 5 16 16 1-4MB (外付) none
R4600 100-133 1994 0.64 2.2 77 179 4.6 5 16 16 512KB (外付) none
R4650 133-180 1994 0.64 2.2? 77? 179? 4.6? 5 16 16 512KB (外付) none
R4700 100-200 1996 0.5 2.2? — 179 — — 16 16 外付 none
R5000 150-200 1996 0.35 3.7 84 223 10 3.3 32 32 1MB (外付) none
R8000 75-90 1994 0.7 2.6 299 591+591 30 3.3 16 16 4MB (外付) none
R10000 150-200 1996 0.35, 0.25 6.7 299 599 30 3.3 32 32 512KB-16MB (外付) none
R12000 270-400 1998 0.25, 0.18 6.9 204 600 20 4 32 32 512KB-16MB (外付) none
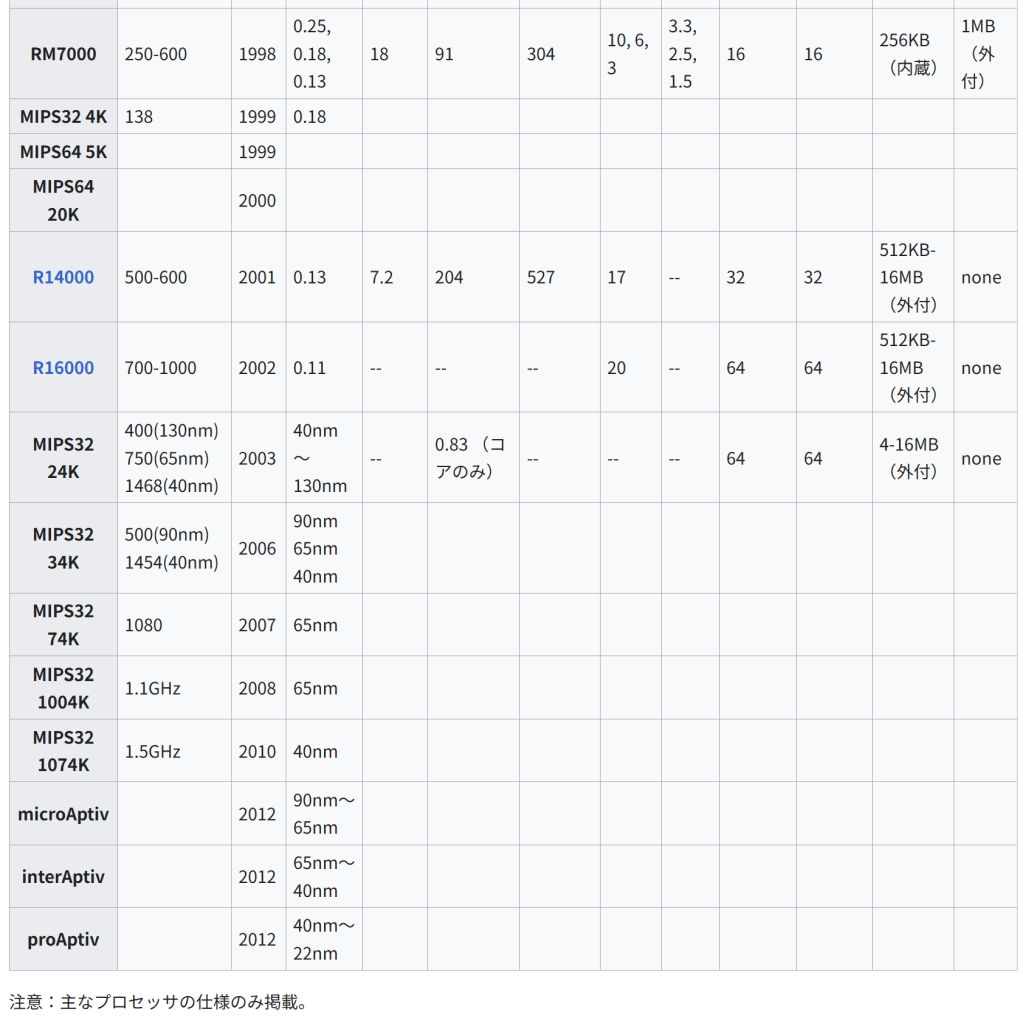
RM7000 250-600 1998 0.25, 0.18, 0.13 18 91 304 10, 6, 3 3.3, 2.5, 1.5 16 16 256KB (内蔵) 1MB (外付)
MIPS32 4K 138 1999 0.18
MIPS64 5K 1999
MIPS64 20K 2000
R14000 500-600 2001 0.13 7.2 204 527 17 — 32 32 512KB-16MB (外付) none
R16000 700-1000 2002 0.11 — — — 20 — 64 64 512KB-16MB (外付) none
MIPS32 24K 400(130nm)
750(65nm)
1468(40nm) 2003 40nm 〜 130nm — 0.83 (コアのみ) — — — 64 64 4-16MB (外付) none
MIPS32 34K 500(90nm)
1454(40nm) 2006 90nm
65nm
40nm
MIPS32 74K 1080 2007 65nm
MIPS32 1004K 1.1GHz 2008 65nm
MIPS32 1074K 1.5GHz 2010 40nm
microAptiv 2012 90nm~65nm
interAptiv 2012 65nm~40nm
proAptiv 2012 40nm~22nm
注意:主なプロセッサの仕様のみ掲載。MIPS I の命令形式
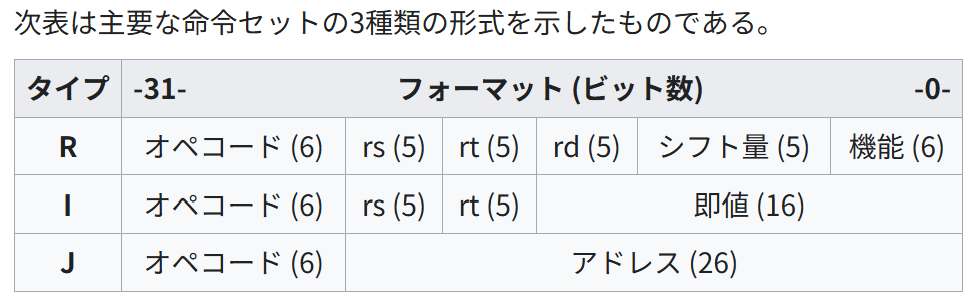
命令は R、I、Jの3種類に分類される。どの命令も先頭に6ビットのオペコードがある。Rタイプではオペコードの次に3本のレジスタを指定するフィールドがあり、シフト量を指定するフィールド、機能を指定するフィールドが続く。Iタイプでは2つのレジスタを指定するフィールドと16ビットの即値のフィールドがある。 Jタイプでは、オペコードに続いて26ビットで分岐先アドレスを指定する[24][25]。次表は主要な命令セットの3種類の形式を示したものである。
タイプ -31- フォーマット (ビット数) -0-
R オペコード (6) rs (5) rt (5) rd (5) シフト量 (5) 機能 (6)
I オペコード (6) rs (5) rt (5) 即値 (16)
J オペコード (6) アドレス (26)
MIPS アセンブリ言語
アセンブリ言語には、直接ハードウェア実装に対応した命令以外に複数命令の列に変換される「擬似命令」が存在する。以下の表で、d、t、s といった文字はレジスタの番号や名前のためのプレースホルダーとなっている。
C は定数(即値)を示す。
オペコード及び機能のコードは16進数である。
MIPS32命令セットでは Add や Subtract 命令で使われる unsigned という用語が誤解を生みやすいとしている。それらの命令の signed と unsigned の違いはオペランドを符号拡張をするかしないかではなく、オーバーフロー発生時にトラップを起こすか (e.g. Add) 無視するか (Add unsigned) である。それらの命令の即値オペランド CONST は常に符号拡張される。
整数
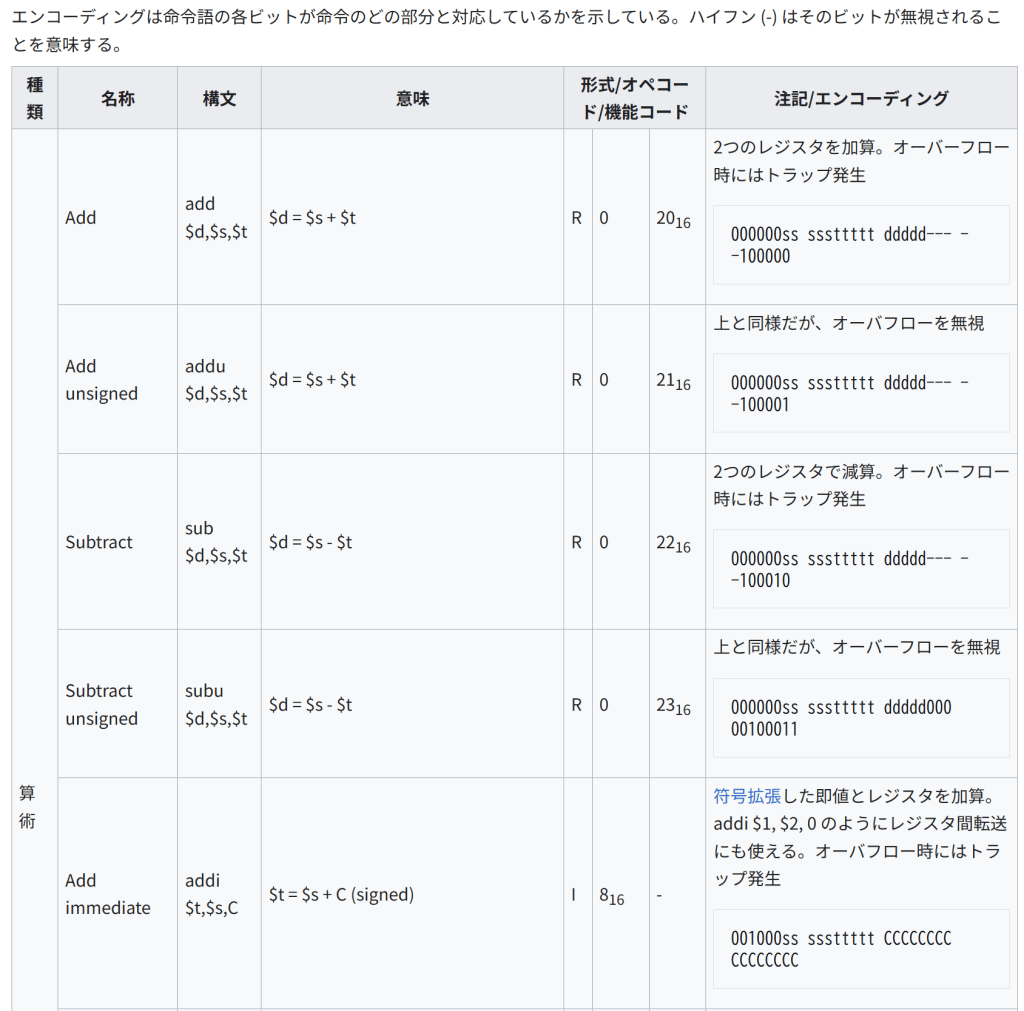
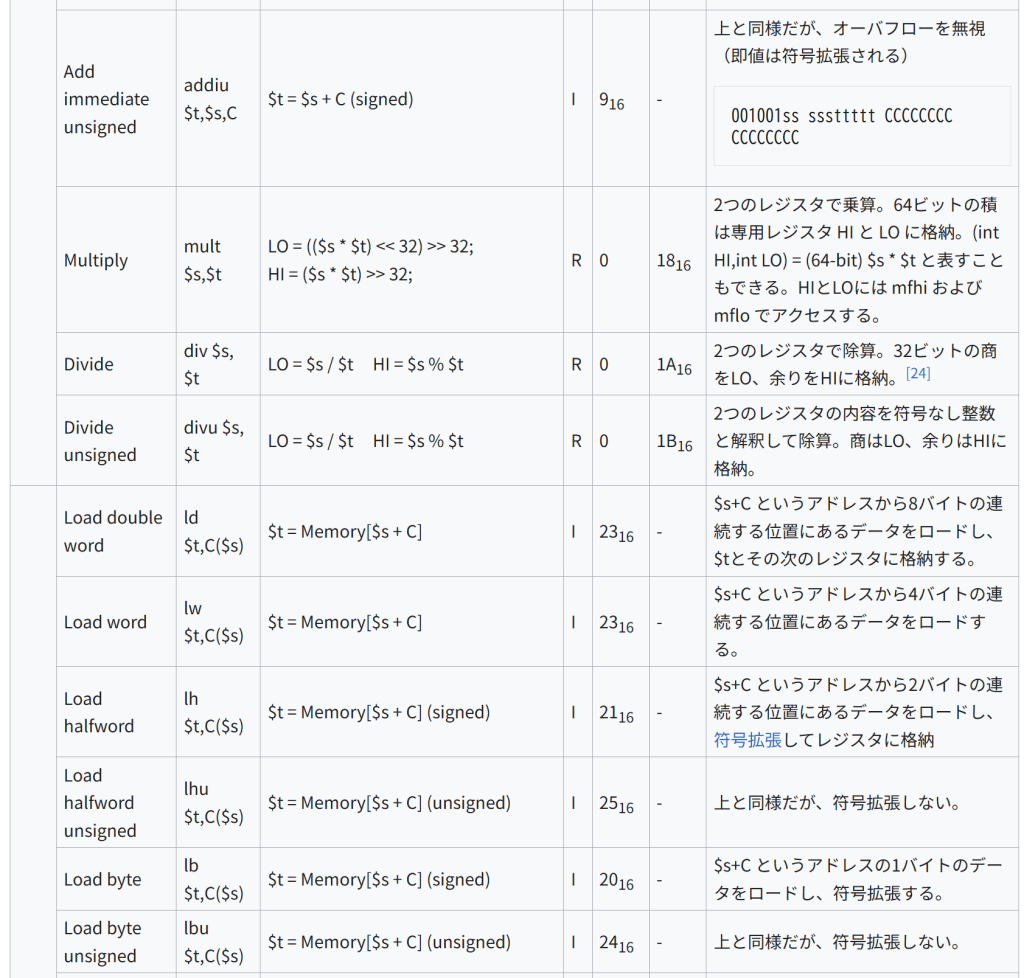
MIPSアーキテクチャは32本の整数レジスタを持つ。算術処理を行うにはデータがレジスタ上になければならない。レジスタ$0は常に0であり、レジスタ$1はアセンブラが一時的に使用する(擬似命令や大きな定数を扱う場合)。エンコーディングは命令語の各ビットが命令のどの部分と対応しているかを示している。ハイフン (-) はそのビットが無視されることを意味する。
種類 名称 構文 意味 形式/オペコード/機能コード 注記/エンコーディング
算術 Add add $d,$s,$t $d = $s + $t R 0 2016 2つのレジスタを加算。オーバーフロー時にはトラップ発生
000000ss sssttttt ddddd— –100000
Add unsigned addu $d,$s,$t $d = $s + $t R 0 2116 上と同様だが、オーバフローを無視
000000ss sssttttt ddddd— –100001
Subtract sub $d,$s,$t $d = $s – $t R 0 2216 2つのレジスタで減算。オーバーフロー時にはトラップ発生
000000ss sssttttt ddddd— –100010
Subtract unsigned subu $d,$s,$t $d = $s – $t R 0 2316 上と同様だが、オーバーフローを無視
000000ss sssttttt ddddd000 00100011
Add immediate addi $t,$s,C $t = $s + C (signed) I 816 – 符号拡張した即値とレジスタを加算。addi $1, $2, 0 のようにレジスタ間転送にも使える。オーバフロー時にはトラップ発生
001000ss sssttttt CCCCCCCC CCCCCCCC
Add immediate unsigned addiu $t,$s,C $t = $s + C (signed) I 916 – 上と同様だが、オーバフローを無視(即値は符号拡張される)
001001ss sssttttt CCCCCCCC CCCCCCCC
Multiply mult $s,$t LO = (($s * $t) << 32) >> 32;
HI = ($s * $t) >> 32; R 0 1816 2つのレジスタで乗算。64ビットの積は専用レジスタ HI と LO に格納。(int HI,int LO) = (64-bit) $s * $t と表すこともできる。HIとLOには mfhi および mflo でアクセスする。
Divide div $s, $t LO = $s / $t HI = $s % $t R 0 1A16 2つのレジスタで除算。32ビットの商をLO、余りをHIに格納。[24]
Divide unsigned divu $s, $t LO = $s / $t HI = $s % $t R 0 1B16 2つのレジスタの内容を符号なし整数と解釈して除算。商はLO、余りはHIに格納。
データ転送 Load double word ld $t,C($s) $t = Memory[$s + C] I 2316 – $s+C というアドレスから8バイトの連続する位置にあるデータをロードし、$tとその次のレジスタに格納する。
Load word lw $t,C($s) $t = Memory[$s + C] I 2316 – $s+C というアドレスから4バイトの連続する位置にあるデータをロードする。
Load halfword lh $t,C($s) $t = Memory$s + C I 2116 – $s+C というアドレスから2バイトの連続する位置にあるデータをロードし、符号拡張してレジスタに格納
Load halfword unsigned lhu $t,C($s) $t = Memory$s + C I 2516 – 上と同様だが、符号拡張しない。
Load byte lb $t,C($s) $t = Memory$s + C I 2016 – $s+C というアドレスの1バイトのデータをロードし、符号拡張する。
Load byte unsigned lbu $t,C($s) $t = Memory$s + C I 2416 – 上と同様だが、符号拡張しない。
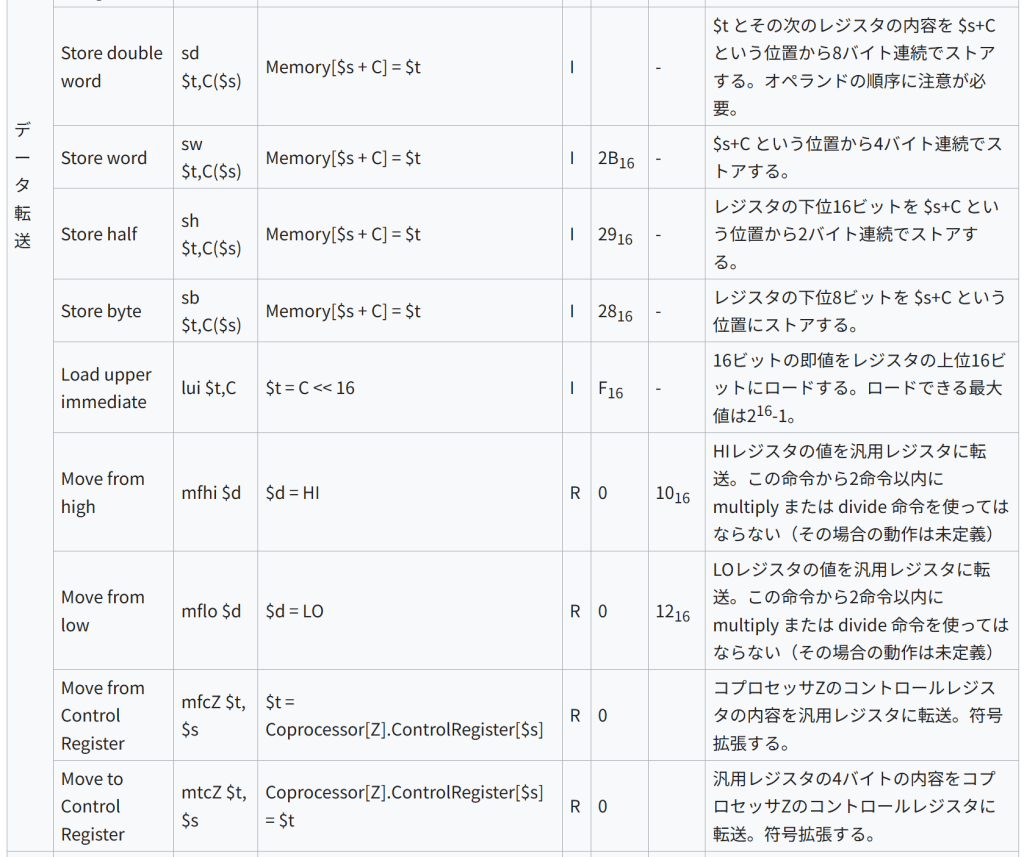
Store double word sd $t,C($s) Memory[$s + C] = $t I – $t とその次のレジスタの内容を $s+C という位置から8バイト連続でストアする。オペランドの順序に注意が必要。
Store word sw $t,C($s) Memory[$s + C] = $t I 2B16 – $s+C という位置から4バイト連続でストアする。
Store half sh $t,C($s) Memory[$s + C] = $t I 2916 – レジスタの下位16ビットを $s+C という位置から2バイト連続でストアする。
Store byte sb $t,C($s) Memory[$s + C] = $t I 2816 – レジスタの下位8ビットを $s+C という位置にストアする。
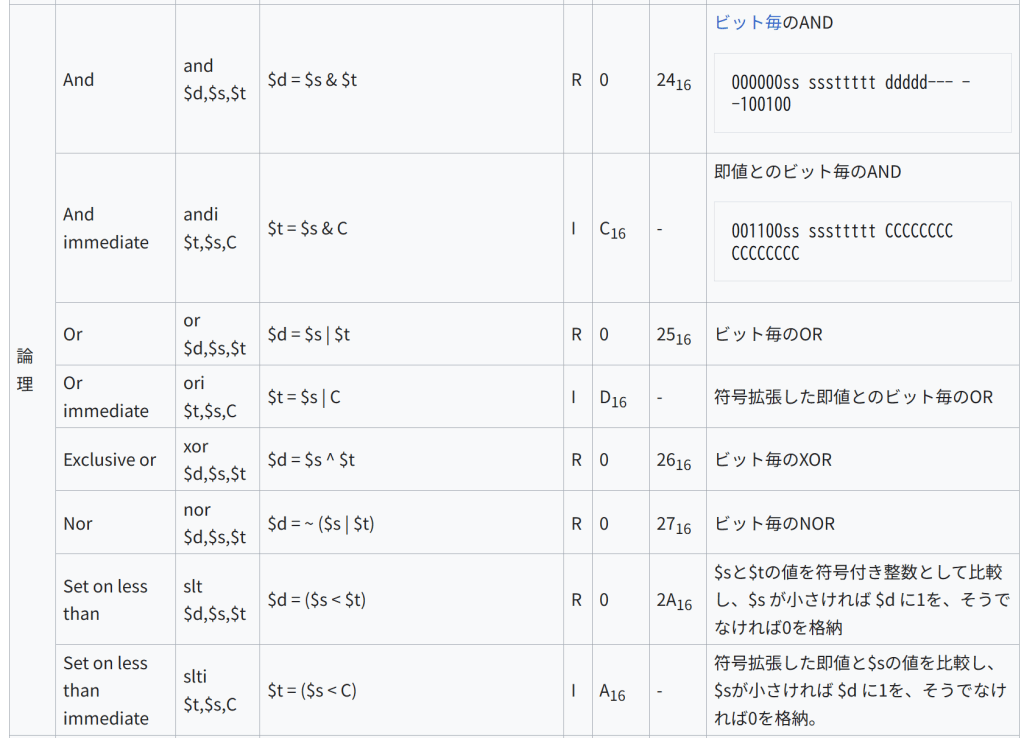
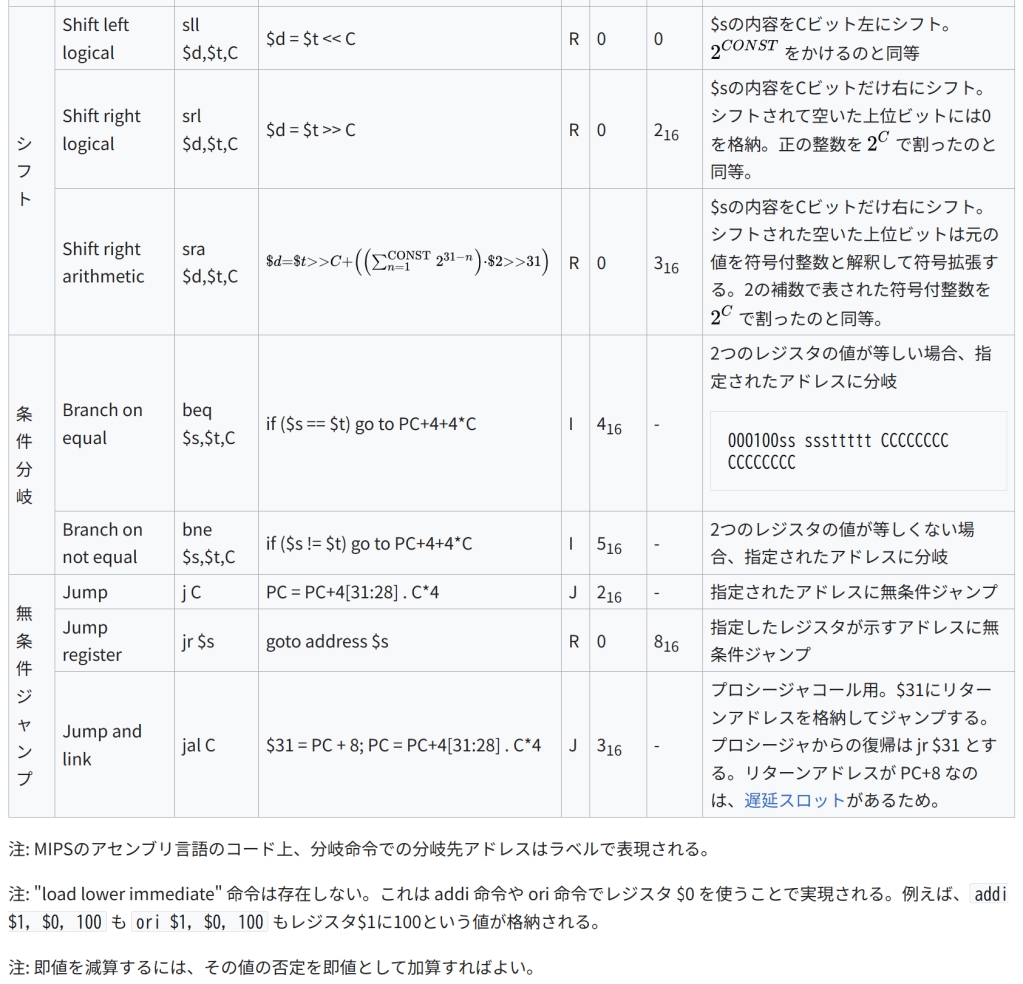
Load upper immediate lui $t,C $t = C << 16 I F16 – 16ビットの即値をレジスタの上位16ビットにロードする。ロードできる最大値は216-1。 Move from high mfhi $d $d = HI R 0 1016 HIレジスタの値を汎用レジスタに転送。この命令から2命令以内に multiply または divide 命令を使ってはならない(その場合の動作は未定義) Move from low mflo $d $d = LO R 0 1216 LOレジスタの値を汎用レジスタに転送。この命令から2命令以内に multiply または divide 命令を使ってはならない(その場合の動作は未定義) Move from Control Register mfcZ $t, $s $t = Coprocessor[Z].ControlRegister[$s] R 0 コプロセッサZのコントロールレジスタの内容を汎用レジスタに転送。符号拡張する。 Move to Control Register mtcZ $t, $s Coprocessor[Z].ControlRegister[$s] = $t R 0 汎用レジスタの4バイトの内容をコプロセッサZのコントロールレジスタに転送。符号拡張する。 論理 And and $d,$s,$t $d = $s & $t R 0 2416 ビット毎のAND 000000ss sssttttt ddddd— –100100 And immediate andi $t,$s,C $t = $s & C I C16 – 即値とのビット毎のAND 001100ss sssttttt CCCCCCCC CCCCCCCC Or or $d,$s,$t $d = $s | $t R 0 2516 ビット毎のOR Or immediate ori $t,$s,C $t = $s | C I D16 – 符号拡張した即値とのビット毎のOR Exclusive or xor $d,$s,$t $d = $s ^ $t R 0 2616 ビット毎のXOR Nor nor $d,$s,$t $d = ~ ($s | $t) R 0 2716 ビット毎のNOR Set on less than slt $d,$s,$t $d = ($s < $t) R 0 2A16 $sと$tの値を符号付き整数として比較し、$s が小さければ $d に1を、そうでなければ0を格納 Set on less than immediate slti $t,$s,C $t = ($s < C) I A16 – 符号拡張した即値と$sの値を比較し、$sが小さければ $d に1を、そうでなければ0を格納。 シフト Shift left logical sll $d,$t,C $d = $t << C R 0 0 $sの内容をCビット左にシフト。 2 C O N S T {\displaystyle 2^{CONST}} をかけるのと同等 Shift right logical srl $d,$t,C $d = $t >> C R 0 216 $sの内容をCビットだけ右にシフト。シフトされて空いた上位ビットには0を格納。正の整数を
2
C
{\displaystyle 2^{C}} で割ったのと同等。
Shift right arithmetic sra $d,$t,C
$d
$
t>
C
+
(
(
∑n
1
CONST
2
31
−
n
)
⋅
$
2
>
31
)
{\displaystyle \scriptstyle \$d=\$t>>C+\left(\left(\sum _{n=1}^{\text{CONST}}2^{31-n}\right)\cdot \$2>>31\right)} R 0 316 $sの内容をCビットだけ右にシフト。シフトされた空いた上位ビットは元の値を符号付整数と解釈して符号拡張する。2の補数で表された符号付整数を
2
C
{\displaystyle 2^{C}} で割ったのと同等。
条件分岐 Branch on equal beq $s,$t,C if ($s == $t) go to PC+4+4C I 416 – 2つのレジスタの値が等しい場合、指定されたアドレスに分岐 000100ss sssttttt CCCCCCCC CCCCCCCC Branch on not equal bne $s,$t,C if ($s != $t) go to PC+4+4C I 516 – 2つのレジスタの値が等しくない場合、指定されたアドレスに分岐
無条件ジャンプ Jump j C PC = PC+4[31:28] . C4 J 216 – 指定されたアドレスに無条件ジャンプ Jump register jr $s goto address $s R 0 816 指定したレジスタが示すアドレスに無条件ジャンプ Jump and link jal C $31 = PC + 8; PC = PC+4[31:28] . C4 J 316 – プロシージャコール用。$31にリターンアドレスを格納してジャンプする。プロシージャからの復帰は jr $31 とする。リターンアドレスが PC+8 なのは、遅延スロットがあるため。
注: MIPSのアセンブリ言語のコード上、分岐命令での分岐先アドレスはラベルで表現される。注: “load lower immediate” 命令は存在しない。これは addi 命令や ori 命令でレジスタ $0 を使うことで実現される。例えば、addi $1, $0, 100 も ori $1, $0, 100 もレジスタ$1に100という値が格納される。
注: 即値を減算するには、その値の否定を即値として加算すればよい。
浮動小数点数
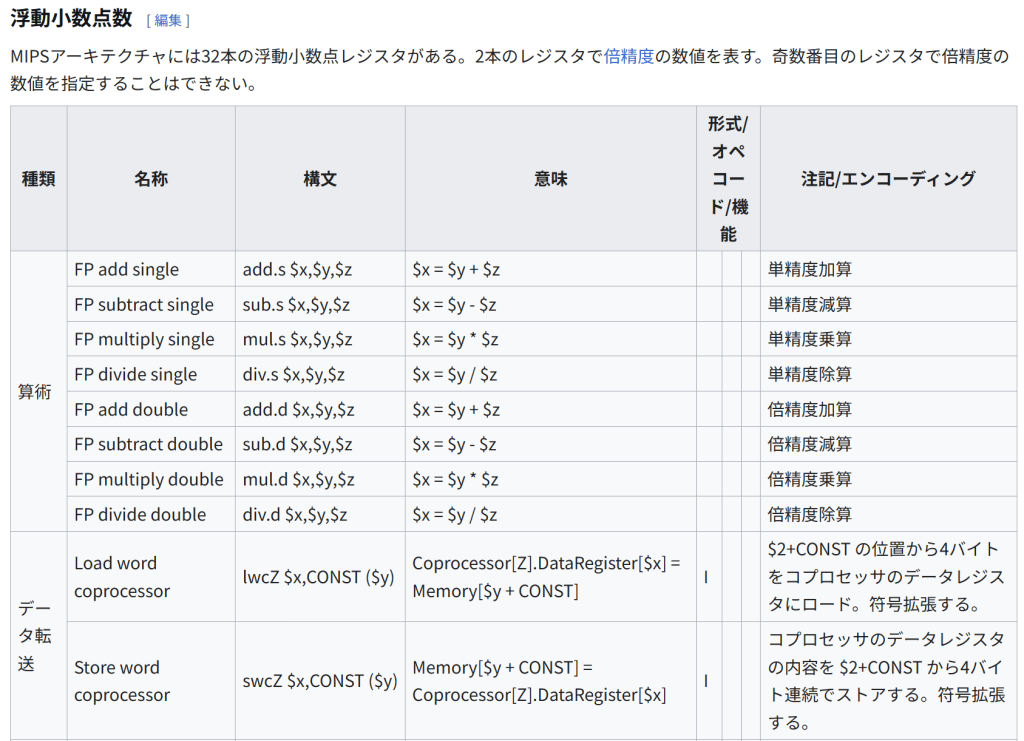
MIPSアーキテクチャには32本の浮動小数点レジスタがある。2本のレジスタで倍精度の数値を表す。奇数番目のレジスタで倍精度の数値を指定することはできない。種類 名称 構文 意味 形式/オペコード/機能 注記/エンコーディング
算術 FP add single add.s $x,$y,$z $x = $y + $z 単精度加算
FP subtract single sub.s $x,$y,$z $x = $y – $z 単精度減算
FP multiply single mul.s $x,$y,$z $x = $y * $z 単精度乗算
FP divide single div.s $x,$y,$z $x = $y / $z 単精度除算
FP add double add.d $x,$y,$z $x = $y + $z 倍精度加算
FP subtract double sub.d $x,$y,$z $x = $y – $z 倍精度減算
FP multiply double mul.d $x,$y,$z $x = $y * $z 倍精度乗算
FP divide double div.d $x,$y,$z $x = $y / $z 倍精度除算
データ転送 Load word coprocessor lwcZ $x,CONST ($y) Coprocessor[Z].DataRegister[$x] = Memory[$y + CONST] I $2+CONST の位置から4バイトをコプロセッサのデータレジスタにロード。符号拡張する。
Store word coprocessor swcZ $x,CONST ($y) Memory[$y + CONST] = Coprocessor[Z].DataRegister[$x] I コプロセッサのデータレジスタの内容を $2+CONST から4バイト連続でストアする。符号拡張する。
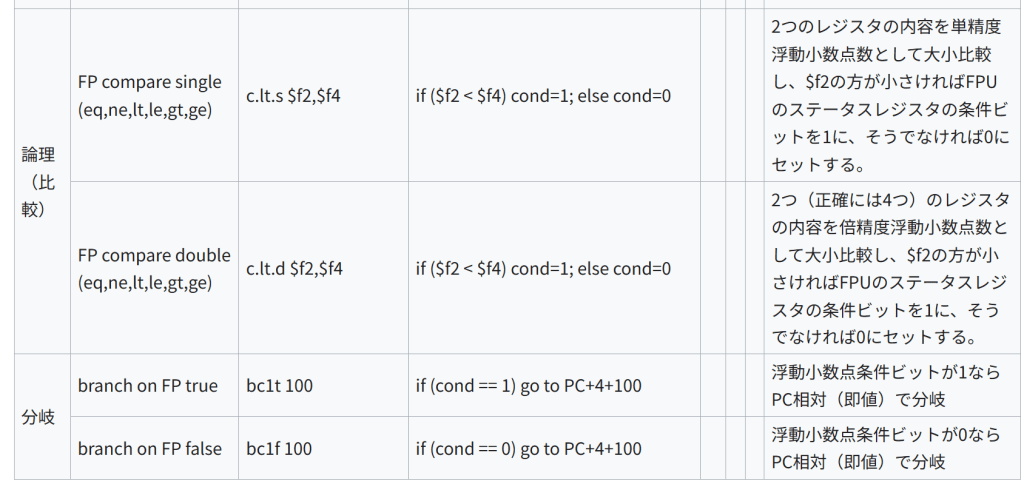
論理(比較) FP compare single (eq,ne,lt,le,gt,ge) c.lt.s $f2,$f4 if ($f2 < $f4) cond=1; else cond=0 2つのレジスタの内容を単精度浮動小数点数として大小比較し、$f2の方が小さければFPUのステータスレジスタの条件ビットを1に、そうでなければ0にセットする。
FP compare double (eq,ne,lt,le,gt,ge) c.lt.d $f2,$f4 if ($f2 < $f4) cond=1; else cond=0 2つ(正確には4つ)のレジスタの内容を倍精度浮動小数点数として大小比較し、$f2の方が小さければFPUのステータスレジスタの条件ビットを1に、そうでなければ0にセットする。
分岐 branch on FP true bc1t 100 if (cond == 1) go to PC+4+100 浮動小数点条件ビットが1ならPC相対(即値)で分岐
branch on FP false bc1f 100 if (cond == 0) go to PC+4+100 浮動小数点条件ビットが0ならPC相対(即値)で分岐
擬似命令
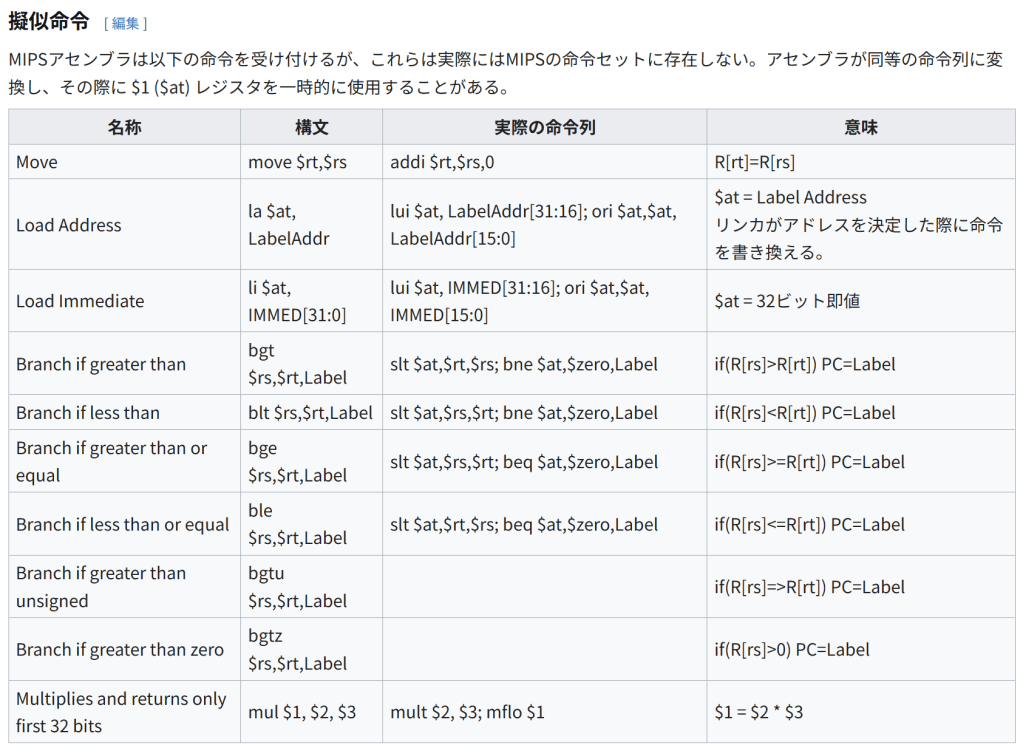
MIPSアセンブラは以下の命令を受け付けるが、これらは実際にはMIPSの命令セットに存在しない。アセンブラが同等の命令列に変換し、その際に $1 ($at) レジスタを一時的に使用することがある。名称 構文 実際の命令列 意味
Move move $rt,$rs addi $rt,$rs,0 R[rt]=R[rs]
Load Address la $at, LabelAddr lui $at, LabelAddr[31:16]; ori $at,$at, LabelAddr[15:0] $at = Label Address
リンカがアドレスを決定した際に命令を書き換える。
Load Immediate li $at, IMMED[31:0] lui $at, IMMED[31:16]; ori $at,$at, IMMED[15:0] $at = 32ビット即値
Branch if greater than bgt $rs,$rt,Label slt $at,$rt,$rs; bne $at,$zero,Label if(R[rs]>R[rt]) PC=Label
Branch if less than blt $rs,$rt,Label slt $at,$rs,$rt; bne $at,$zero,Label if(R[rs]=R[rt]) PC=Label
Branch if less than or equal ble $rs,$rt,Label slt $at,$rt,$rs; beq $at,$zero,Label if(R[rs]<=R[rt]) PC=Label Branch if greater than unsigned bgtu $rs,$rt,Label if(R[rs]=>R[rt]) PC=Label
Branch if greater than zero bgtz $rs,$rt,Label if(R[rs]>0) PC=Label
Multiplies and returns only first 32 bits mul $1, $2, $3 mult $2, $3; mflo $1 $1 = $2 * $3
その他の命令
NOP命令。通常 sll $0,$0,0 という命令を使い、その機械語コードは 0x00000000 となる。
break命令。デバッガでのブレークポイント設定で使用する。
syscall命令。オペレーティングシステムのシステムコールに使われ、ユーザーモードからカーネルモードに移行する。
コンパイラのレジスタ使用規則
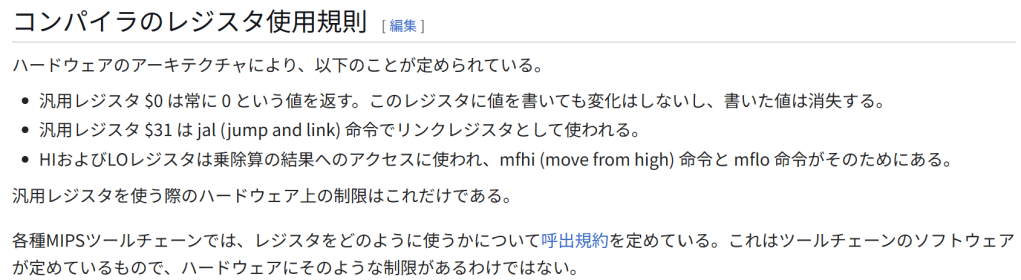
ハードウェアのアーキテクチャにより、以下のことが定められている。汎用レジスタ $0 は常に 0 という値を返す。このレジスタに値を書いても変化はしないし、書いた値は消失する。
汎用レジスタ $31 は jal (jump and link) 命令でリンクレジスタとして使われる。
HIおよびLOレジスタは乗除算の結果へのアクセスに使われ、mfhi (move from high) 命令と mflo 命令がそのためにある。
汎用レジスタを使う際のハードウェア上の制限はこれだけである。各種MIPSツールチェーンでは、レジスタをどのように使うかについて呼出規約を定めている。これはツールチェーンのソフトウェアが定めているもので、ハードウェアにそのような制限があるわけではない。
レジスタ
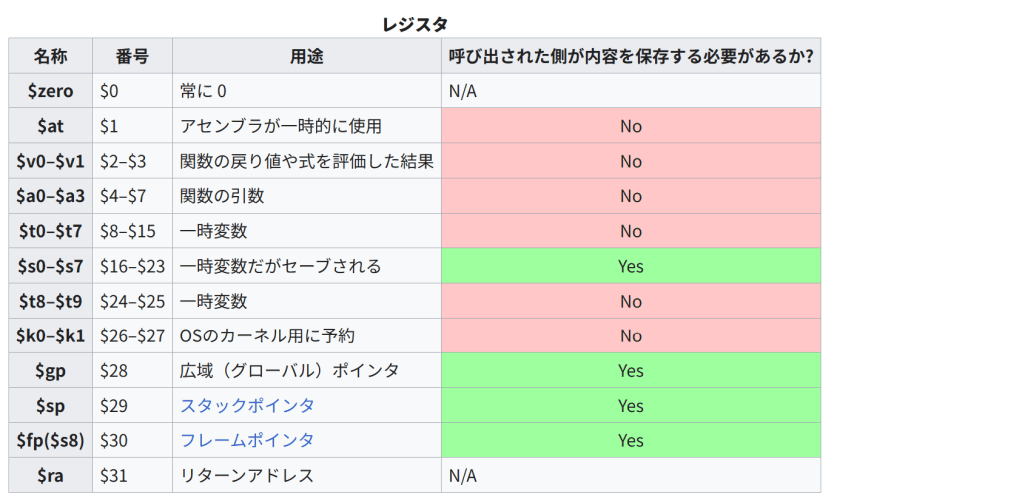
名称 番号 用途 呼び出された側が内容を保存する必要があるか?
$zero $0 常に 0 N/A
$at $1 アセンブラが一時的に使用 No
$v0–$v1 $2–$3 関数の戻り値や式を評価した結果 No
$a0–$a3 $4–$7 関数の引数 No
$t0–$t7 $8–$15 一時変数 No
$s0–$s7 $16–$23 一時変数だがセーブされる Yes
$t8–$t9 $24–$25 一時変数 No
$k0–$k1 $26–$27 OSのカーネル用に予約 No
$gp $28 広域(グローバル)ポインタ Yes
$sp $29 スタックポインタ Yes
$fp($s8) $30 フレームポインタ Yes
$ra $31 リターンアドレス N/A
呼び出された側が保存すると定められているレジスタは、サブルーチンや関数の呼び出しやシステムコールでも保持される。例えば、$s-レジスタをルーチン内で使うときは、その内容をスタックに一時的に退避させなければならない。$sp と $fp はルーチンに入ってきたときにセーブされ、それぞれルーチン固有の固定値でインクリメントされる。そして、そのルーチンから戻るときに元の値に戻す。一方 $ra は jal 命令でルーチンに飛び込むときに自動的に変更される。$t-レジスタはサブルーチンを呼び出すと内容が破壊されるので、必要なら呼び出す側がセーブしておかなければならない。シミュレータ
Open Virtual Platforms (OVP)[26] では、非商用利用に限って無料で使えるシミュレータ OVPsim、プロセッサや周辺機器やプラットフォームのモデルのライブラリ、ユーザーが独自のモデルを開発できるAPIなどを提供している。ライブラリに含まれるモデルはオープンソースでC言語で書かれており、MIPSの 4K, 24K, 34K, 74K, 1004K, 1074K, M14K といったコアが揃っている。それらのモデルの開発と保守は Imperas が行っており[27]、ミップス・テクノロジーズの協力の下で評価し MIPS-Verified ™ というマークをもらっている。MIPSベースのプラットフォームのモデルとしては、非常に単純なものとLinuxのバイナリイメージをブートできるものが用意されている。それらのプラットフォーム・エミュレータはソースとバイナリの形で提供されており、高速で使いやすい。また、教育向けのMIPS32(当初はR2000/R3000をシミュレートしていた)のフリーなシミュレータ SPIM がある[28]。EduMIPS64[29] は、GPLライセンスのグラフィカルなMIPS64シミュレータで、Java/Swingで書かれている。MIPS64 ISA の大部分をカバーするサブセットをサポートしており、アセンブリ言語で書かれたプログラムを実行したときCPU内のパイプラインで何が起きているかをグラフィカルに表示する。こちらも教育向けで、世界各地の大学で利用されている。
MARS[30] もGUIベースのMIPSエミュレータで教育向けに作られており、特にヘネシーの『コンピュータの構成と設計』を教科書として使う際に役立つよう設計されている。
より実用的なフリーなエミュレータとしてGXemulやQEMUプロジェクトのものがある。MIPS III および IV のプロセッサをエミュレートでき、コンピュータシステム全体のエミュレートも可能である。
商用のシミュレータは主に組み込み用MIPSプロセッサを対象としたものが存在する。例えば、Virtutech Simics (MIPS 4Kc and 5Kc, PMC RM9000, QED RM7000)、VaST Systems (R3000, R4000)、CoWare (MIPS4KE, MIPS24K, MIPS25Kf, MIPS34K) がある。
脚注
[脚注の使い方]
注釈
^ MIPS社のR4000が登場する頃には、DEC社は自社製RISCマイクロプロセッサAlphaを完成させてこれに切り替えた。
^ R4000は、スーパーパイプラインを世界で最初に導入した市販のマイクロプロセッサである。しかし、これによって、”Microprocessor with Interlocked Pipeline Stages” パイプライン・ステージがインターロックされるマイクロプロセッサと揶揄されることになった。
出典
^ “MIPS32 Architecture”. ミップス・テクノロジーズ. 2009年5月27日閲覧。
^ “MIPS64 Architecture”. ミップス・テクノロジーズ. 2009年5月27日閲覧。
^ “MIPS-3D ASE”. ミップス・テクノロジーズ. 2009年5月27日閲覧。
^ “MIPS16e”. ミップス・テクノロジーズ. 2021年1月14日閲覧。
^ “MIPS MT ASE”. ミップス・テクノロジーズ. 2009年5月27日閲覧。
^ University of California, Davis. “ECS 142 (Compilers) References & Tools page”. 2009年5月28日閲覧。
^ Rubio, Victor P. “A FPGA Implementation of a MIPS RISC Processor for Computer Architecture Education”. New Mexico State University. 2011年12月22日閲覧。
^ a b 神保進一著、『マイクロプロセッサ テクノロジ』、日経BP社、1999年12月6日第1版第1刷発行、ISBN 4822209261
^ Morgan Kaufmann Publishers, Computer Organization and Design, David A. Patterson & John L. Hennessy, Edition 3, ISBN 1-55860-604-1, page 63
^ “Earl Killian”. Paravirtual. (2010年11月26日) 2010年11月26日閲覧。 ⚠
^ “S-1 Supercomputer Alumni: Earl Killian”. Clemson University. (2005年6月28日) 2010年11月26日閲覧. “Earl Killian’s early work w… As MIPS’s Director of Architecture, he designed the MIPS III 64-bit instruction-set extension, and led the work on the R4000 microarchitecture. He was a cofounder of QED, which created the R4600 and R5000 MIPS processors. Most recently he was chief architect at Tensilica working on configurable/extensible processors.” ⚠
^ Jochen Liedtke(1995). On micro kernel construction. 15th Symposium on Operating Systems Principles, Copper Mountain Resort, Colorado.
^ “MIPS® Architecture For Programmers Volume II-A: The MIPS32® Instruction Set Document Number: MD00086 Revision 5.04 December 11, 2013”. p. 41. 2023年12月9日閲覧。
^ SGI announcing the end of MIPS – ウェイバックマシン(2008年3月7日アーカイブ分)
^ CPUコアベンダからの脱却 – 変貌するMIPS Technologiesの実像を探る
^ http://www.mdronline.com/mpr/h/2006/0626/202602.html China’s Microprocessor Dilemma
^ China’s Institute of Computing Technology Licenses Industry-Standard MIPS Architectures
^ “LinuxDevices article about the Municator”. 2012年12月16日時点のオリジナルよりアーカイブ。2010年12月12日閲覧。
^ “Yeelong Specs”. 2012年12月10日時点のオリジナルよりアーカイブ。2010年12月12日閲覧。 (LinuxDevices, Oct. 22, 2008)
^ “Silicon Graphics Introduces Enhanced MIPS Architecture to Lead the Interactive Digital Revolution”. Silicon Graphics, Inc. (1996年10月21日). 2011年2月25日閲覧。
^ a b Gwennap, Linley (18 November 1996). “Digital, MIPS Add Multimedia Extensions”. Microprocessor Report. pp. 24–28.
^ NEC Offers Two High Cost Performance 64-bit RISC Microprocessors
^ 編集人 山形孝雄「PMC-Sierra RMシリーズの概要とRM7900&RM900x2Gの詳細」『Interface2004年7月号』CQ出版社、2004年7月1日、77-88頁。ISSN 0387-9569。
^ a b MIPS R3000 Instruction Set Summary
^ MIPS Instruction Reference
^ Welcome Page | Open Virtual Platforms
^ Welcome to Imperas | Imperas
^ James Larus. “SPIM MIPS Simulator”. 2007年3月4日閲覧。
^ EduMIPS64
^ MARS MIPS simulator – Missouri State University
参考文献
David A. Patterson and John L. Hennessy (2007). Computer Organization and Design: The Hardware/Software Interface. Morgan Kaufmann Publishers. ISBN 978-0-12-370606-5
David A. Patterson and John L. Hennessy; 成田光彰 (2006). コンピュータの構成と設計 第3版(上) ハードウエアとソフトウエアのインタフェース. 日経BP. ISBN 4-8222-8266-X
David A. Patterson and John L. Hennessy; 成田光彰 (2006). コンピュータの構成と設計 第3版(下) ハードウエアとソフトウエアのインタフェース. 日経BP. ISBN 4-8222-8267-8
プロセッサを中心としたコンピュータの設計全般に関する書籍で、命令セットの例としてMIPSアーキテクチャを取り上げている。MIPS開発者であるジョン・L・ヘネシーも著者の一人である。
Dominic Sweetman. See MIPS Run. Morgan Kaufmann Publishers. ISBN 1-55860-410-3
MIPSアーキテクチャについての決定版的な本。ハードウェアアーキテクチャだけでなく、コンパイラやOSについても詳述している。
Farquhar, Erin; Philip Bunce. MIPS Programmer’s Handbook. Morgan Kaufmann Publishers. ISBN 1-55860-297-6
関連項目
μClinux
PlayStation – CPUとしてR3000Aを搭載。
外部リンク
MIPS Architectures at MIPS Technologies
Full overview of MIPS architecture
Patterson & Hennessy – Appendix A
Summary of MIPS assembly language
MIPS Instruction reference
MARS (MIPS Assembler and Runtime Simulator)
MIPS processor images and descriptions at cpu-collection.de
A programmed introduction to MIPS assembly
Mips bitshift operators
MIPS software user’s manual
MIPS Architecture history diagram
MIPS Open initiative # 2018年12月17日(米国時間)にWave Computing社はMIPS Open(MIPS命令セットアーキテクチャ(ISA)のオープンソース化プログラム)を発表。
表話編歴
MIPSマイクロプロセッサ
表話編歴
プロセッサアーキテクチャ
典拠管理データベース: 国立図書館 ウィキデータを編集
イスラエルアメリカ
カテゴリ: MIPSアーキテクチャコンピュータアーキテクチャMIPSのマイクロプロセッサ命令セットアーキテクチャアドバンスドRISCコンソーシアム
最終更新 2025年1月30日 (木) 08:43 (日時は個人設定で未設定ならばUTC)。
テキストはクリエイティブ・コモンズ 表示-継承ライセンスのもとで利用できます。追加の条件が適用される場合があります。詳細については利用規約を参照してください。』


- 2026年10月
- 2026年9月
- 2026年8月
- 2026年7月
- 2026年6月
- 2026年5月
- 2026年4月
- 2026年1月
- 2025年12月
- 2025年11月
- 2025年10月
- 2025年9月
- 2025年8月
- 2025年7月
- 2025年5月
- 2025年4月
- 2025年3月
- 2025年2月
- 2025年1月
- 2024年12月
- 2024年11月
- 2024年10月
- 2024年9月
- 2024年7月
- 2024年6月
- 2024年5月
- 2024年4月
- 2024年3月
- 2024年2月
- 2024年1月
- 2023年12月
- 2023年11月
- 2023年10月
- 2023年9月
- 2023年8月
- 2023年7月
- 2023年6月
- 2023年5月
- 2023年4月
- 2023年3月
- 2023年2月
- 2023年1月
- 2022年12月
- 2022年11月
- 2022年10月
- 2022年9月
- 2022年8月
- 2022年7月
- 2022年6月
- 2022年5月
- 2022年4月
- 2022年3月
- 2022年1月
- 2021年12月
- 2021年11月
- 2021年10月
- 2021年9月
- 2021年8月
- 2021年7月
- 2021年6月
- 2021年5月
- 2021年4月
- 2021年3月
- 2021年2月
- 2021年1月
- 2020年12月
- 2020年11月
- 2020年10月
- 2020年9月
- 2020年8月
- 2020年7月
- 2020年6月
- 2020年5月
- 2020年4月
- 2020年3月
- 2020年2月
- 2020年1月
- 2019年12月
- 2019年11月
- 2019年10月
- 2019年9月
- 2019年8月
- 2019年7月
- 2019年6月
- 2019年5月
- 2019年2月
- 2018年12月
- 2018年11月
- 2018年10月
- 2018年9月
- 2018年8月
- アルゴリズム、関連
- インドの戦略
- イージス ・アショア
- エネルギー資源
- クルーズ船、関連
- ゲーム、関連
- ゲーム理論
- コロナの日本経済への影響
- コロナの世界経済への影響
- コロナウィルス、関連
- コロナ・ウイルス、関連
- コロナ後の日本の情勢、関連
- コロナ後の世界情勢
- コロナ支援策、関連
- コンピューター、関連
- コンピューターの歴史、関連
- サイエンス
- サイバー攻撃、関連
- サブリース
- サプライチェーン、関連
- システム開発、関連
- システム障害、関連
- スキル、リスキリング、関連
- スタートアップ、関連
- スパコン、関連
- スポーツ、関連
- スマホ、関連
- ソーラーパネル
- テクノロジー
- ディープフェイク
- デジタル・データ、関連
- デジタル通貨
- データサイエンス、関連
- データ解析、関連
- ネットワーク、関連
- ハッキング、関連
- ハード、関連
- ハード関連企業、関連
- バックアップ、関連
- パソコン、関連
- ファンタジー、ナラティブ、関連
- フィンテック、関連
- プログラミング、関連
- マスクなど、関連
- マルウェア、関連
- マルウェア、関連
- メンタルケア、関連
- リモート・ワーク、関連
- リーダー像、リーダー論、関連
- リーマンショックと世界経済
- ロシア、関連
- ロシアの戦略
- ワクチン開発、関連
- ワクチン製造、流通、関連
- ワクチン接種、関連
- ワクチン接種証明書、関連
- CPU、関連
- 物流、関連
- 現場力
- 現代社会、一般
- 環境破壊、関連
- 病変、関連
- 石破政権、関連
- 社会、関連
- 税制、関連
- 米国、関連
- 米中
- 米中摩擦
- 精神、心理、関連
- 精神・心理の操作、関連
- 精神活動
- 組織論、関連
- 経済との両立、関連
- 経済関係
- 美術、関連
- 違法薬物、関連
- 肺炎、関連
- 脱炭素、関連
- 脱炭素、関連
- 脳科学
- 量子コンピュータ、関連
- 自動運転、関連
- 自動車産業、関連
- 鉱物資源
- 菅内閣、政策、関連
- 音楽、関連
- 食料資源、関連
- 食料資源、関連
- 観光資源、関連
- 解析・分析、論文、関連
- 言語、関連
- 騙し
- 高市政権、関連
- 資源
- FTA、EPAなど、関連
- GDP、関連
- GPU、関連
- 3D描画、関連
- 5G、関連
- AI、関連
- IT関連
- IT関連の犯罪
- IT関連の詐欺
- IT関連の政策
- IT利用企業、関連
- IT企業、関連
- IT企業の規制、関連
- NATO
- NATOの
- OS、関連
- PCパーツ、関連
- RPA、業務の自動化、関連
- SNS、関連
- Uncategorized
- VR、AR、関連
- Windows10、関連
- Windows11、関連
- Z世代、関連
- 個人の尊重、関連
- 個人の尊厳、関連
- 個人情報の流出、関連
- 倒産処理、関係
- 健康、関連
- 債務
- 免役体制、関連
- 刑法、関連
- 医療用防護具、関連
- 半導体、関連
- 半導体、製造、関連
- 半導体、設計、関連
- 半導体、供給、関連
- 哲学、関連
- 国際組織、関連
- 国際機関、関連
- 国際法、関連
- 国際会議、協議、関連
- 国際会議、協議、関連
- 国内、インフラ、関連
- 国内、シンクタンク、関連
- 国内、デジタル・オンライン化、関連
- 国内、ネットワーク、関連
- 国内、災害、関連
- 国内、犯罪、関連
- 国内、異民族、関連
- 国内、税制、関連
- 国内、経済、関連
- 国内、金融、関連
- 国内、行政手続き、関連
- 国内、観光資源、関連
- 国内、諸統計、関連
- 国内、農林水産業、関連
- 国内、個別企業、関連
- 国内、入出国管理、関連
- 国内、労働組合、関連
- 国内、司法、関連
- 国内、国民の安全保護、関連
- 国内、地理、関連
- 国内、地方自治、関連
- 国内、官界、関連
- 国内、情報流出、関連
- 国内、感染症、関連
- 国内、政治
- 国内、政治、政局関連
- 国内、教育、関連
- 国内、文化活動、関連
- 国内、歴史、関連
- 国内、事故、関連
- 国内、事件、関連
- 国内、交通、関連
- 国内経済への影響、関連
- 国内情勢
- 地政学
- 宇宙開発・探査、関連
- 宗教、関連
- 岸田政権、関連
- 建設・建築、関連
- 心理学、関連
- 思考法、関連
- 怪しい情報
- 情報処理理論、関連
- 感染対策、関連
- 憲法、人権、関連
- 戦略論
- 拡大防止対策、関連
- 数学、関連
- 文学、関連
- 新型コロナ
- 新型コロナの後遺症、関連
- 日米関係
- 日本の社会
- 日本の防衛
- 日本の製造業、関連
- 日本の宇宙開発、関連
- 日本の安全保障
- 日本の感染状況
- 日本の戦略
- 日本関連の海外活動
- 日本論、日本人論、関連
- 日本国の潜在資源、関連
- 日中関係
- 暗号通貨
- 暗号資産、関連
- 暗号資産、関連
- 東京2020、関連
- 株・日経平均、関連
- 歴史、関連
- 比較法制、関連
- 民法、関連
- 民主主義、関連
- 民事訴訟、関連
- 気象、関連
- 気象、関連
- 気候変動対策、関連
- 水産資源、関連
- 水資源
- 治療方法、関連
- 法律的な話し
- 一帯一路との関連
- 世界の考古学
- 世界の地理、関連
- 世界の感染状況
- 世界の教育、関連
- 世界の文化、関連
- 世界の歴史、関連
- 世界経済、関連
- 世界情勢
- 中国
- 中国の戦略
- 中国の政治体制、関連
- 事故、災害、関連
- 事件、関連
- 人生、人間性、関連
- 人生設計、関連
- 人口、関連
- 仕事、ビジネス、関連
- 企業会計、関連
- 漫画、アニメ
- 保守・管理業務、関連

