まず、今私が書いている英語の論文のイントロを丸ごと読ませたら、2秒ほどしてから、数箇所の改善の示唆をしたあと、”Overall, the text is well-written and the grammar is sound.”と言ってくれた。論文のグラフをRで作成するのに試行錯誤で数日を費やしたが、もしChatGPTを使っていたら、この作業は1日に短縮できたと思う。
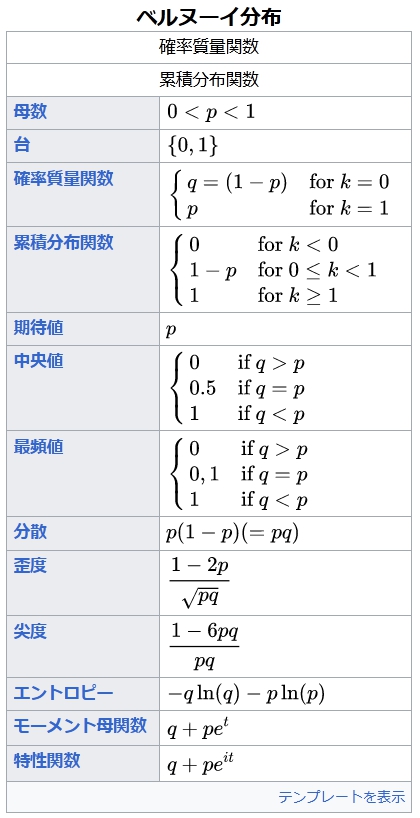
ベルヌーイ分布 確率質量関数 累積分布関数 母数 0 < p < 1 {\displaystyle 0 p 0.5 if q = p 1 if q < p {\displaystyle {\begin{cases}0&{\text{if }}q>p\0.5&{\text{if }}q=p\1&{\text{if }}q p 0 , 1 if q = p 1 if q < p {\displaystyle {\begin{cases}0&{\text{if }}q>p\0,1&{\text{if }}q=p\1&{\text{if }}q<p\end{cases}}} 分散 p ( 1 − p ) ( = p q ) {\displaystyle p(1-p)(=pq)} 歪度 1 − 2 p p q {\displaystyle {\frac {1-2p}{\sqrt {pq}}}} 尖度 1 − 6 p q p q {\displaystyle {\frac {1-6pq}{pq}}} エントロピー − q ln ( q ) − p ln ( p ) {\displaystyle -q\ln(q)-p\ln(p)} モーメント母関数 q + p e t {\displaystyle q+pe^{t}} 特性関数 q + p e i t {\displaystyle q+pe^{it}} テンプレートを表示
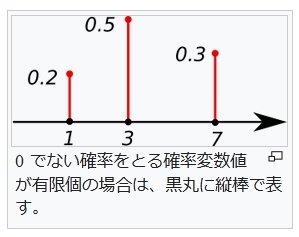
ベルヌーイ分布(英: Bernoulli distribution)とは、数学において、確率 p で 1 を、確率 q = 1 − p で 0 をとる、離散確率分布である。
ベルヌーイ分布という名前は、スイスの科学者ヤコブ・ベルヌーイに因んでつけられた名前である。
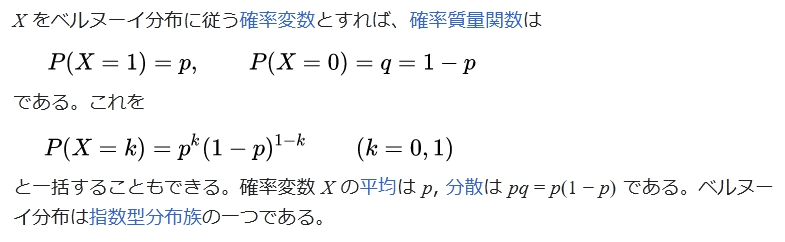
X をベルヌーイ分布に従う確率変数とすれば、確率質量関数は
P ( X = 1 ) = p , P ( X = 0 ) = q = 1 − p {\displaystyle P(X=1)=p,\qquad P(X=0)=q=1-p}
である。これを
P ( X = k ) = p k ( 1 − p ) 1 − k ( k = 0 , 1 ) {\displaystyle P(X=k)=p^{k}(1-p)^{1-k}\qquad (k=0,1)}
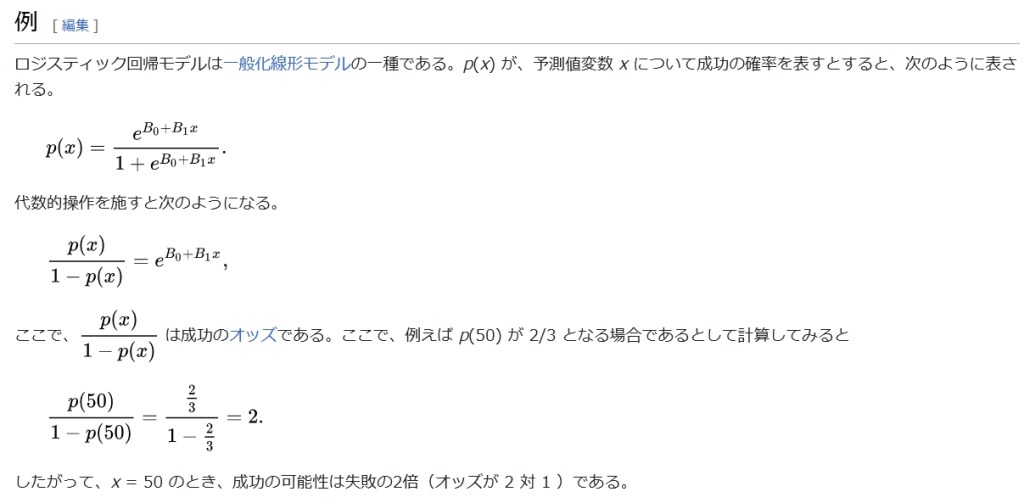
logit ( p i ) = ln ( p i 1 − p i ) = α + β 1 x 1 , i + ⋯ + β k x k , i , {\displaystyle \operatorname {logit} (p_{i})=\ln \left({\frac {p_{i}}{1-p_{i}}}\right)=\alpha +\beta {1}x{1,i}+\cdots +\beta {k}x{k,i},} i = 1 , … , n , {\displaystyle i=1,\dots ,n,\,!}
ここで、n 個のユニットと共変動 X があり、以下のような関係にある。
p i = E ( Y | X i ) = Pr ( Y i = 1 ) . {\displaystyle p_{i}=E(Y|X_{i})=\Pr(Y_{i}=1).\,!}
結果のオッズ(1から確率を引いたもので確率を割った値)の対数は、説明変数 Xi の線形関数としてモデル化される。これを次のようにも表せる。
p i = Pr ( Y i = 1 | X ) = 1 1 + e − ( α + β 1 x 1 , i + ⋯ + β k x k , i ) {\displaystyle p_{i}=\Pr(Y_{i}=1|X)={\frac {1}{1+e^{-(\alpha +\beta {1}x{1,i}+\cdots +\beta {k}x{k,i})}}}}
Agresti, Alan, Categorical Data Analysis, 2nd ed., New York: Wiley-Interscience, 2002, ISBN 0-471-36093-7.
Amemiya, T., Advanced Econometrics, Harvard University Press, 1985, ISBN 0-674-00560-0.
Balakrishnan, N., Handbook of the Logistic Distribution, Marcel Dekker Inc., 1991, ISBN 0824785878.
Green, William H., Econometric Analysis, fifth edition, Prentice Hall, 2003, ISBN 0-13-066189-9.
Hosmer, David W. and Stanley Lemeshow, Applied Logistic Regression, 2nd ed., New York; Chichester, Wiley, 2000, ISBN 0-471-35632-8.
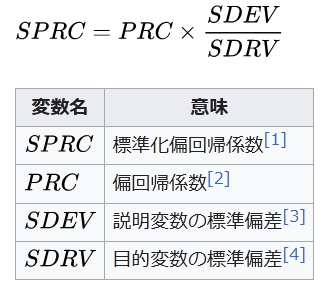
S P R C = P R C × S D E V S D R V {\displaystyle SPRC=PRC\times {\frac {SDEV}{SDRV}}}
変数名     意味
S P R C {\displaystyle SPRC}     標準化偏回帰係数[1]
P R C {\displaystyle PRC}     偏回帰係数[2]
S D E V {\displaystyle SDEV}     説明変数の標準偏差[3]
S D R V {\displaystyle SDRV}     目的変数の標準偏差[4]
例
中学生を対象に調査を行いその結果を重回帰分析したところ下の式が得られたとする。
t C × 3 + t S J × 5 + 20 = n {\displaystyle t_{C}\times 3+t_{SJ}\times 5+20=n}

変数名     意味

t C {\displaystyle t_{C}}     中学で勉強した時間数

t S J {\displaystyle t_{SJ}}     小学生の時代の塾の学習時間数

n {\displaystyle n}     知っている英単語の数
Microsoft Excel
SAS
Stata
SPSS
College Analysis
多変量解析入門

R言語 - 統計解析言語。重回帰分析だけでなく多変量解析ほか多くの統計関数を標準装備したフリーウェア。『モデル式』でモデル記述や当てはめが容易。他アプリケーションのファイル取込やODBC接続対応。FDA公認。CRANなる仕組で世界の膨大なソフトを無償利用可能。可視化機能に優れ、日本語対応。マルチプラットフォーム。Rの基本パッケージ中の回帰、分散分析関数一覧。重回帰分析はlm関数で行えるほか、独自に書かれた関数もある: [1][2]。
NAG
IMSL
R言語 - 統計解析言語。回帰分析ほか多くの統計関数を標準装備したフリーウェア。『モデル式』でモデル記述や当てはめが容易。他アプリケーションのファイル取込やODBC接続対応。FDA公認。CRANという仕組みで世界の膨大なソフトを無償利用可能。可視化機能に優れ、日本語対応。マルチプラットフォーム。
Stata
Gretl
脚注
^ 『統計学入門』(東京大学出版会)、257頁
参考文献
『統計学入門』東京大学出版会、1991年。
J. R. Taylor 著、林茂雄、馬場凉(訳) 編『計測における誤差解析入門』東京化学同人、2000年。
蓑谷千凰彦『回帰分析のはなし』東京図書、1985年。